Bootstrapping SmartPLS: Hướng dẫn chi tiết cho phân tích dữ liệu
Giới thiệu về Bootstrapping trong SmartPLS
Tại sao Bootstrapping là cần thiết cho phân tích mô hình?
Khi nào nên sử dụng Bootstrapping SmartPLS?
- Các tác động trực tiếp (Direct effects) giữa các biến.
- Các tác động gián tiếp (Indirect effects) thông qua biến trung gian.
- Các tác động điều tiết (Moderating effects) của biến điều tiết.
Lợi ích của việc áp dụng Bootstrapping trong nghiên cứu
- Không đòi hỏi giả định phân phối chuẩn: Đây là lợi ích lớn nhất, cho phép bạn phân tích các bộ dữ liệu không tuân theo quy luật phân phối chuẩn, một tình huống rất phổ biến trong thực tế.
- Hiệu quả với cỡ mẫu nhỏ: Dù cỡ mẫu lớn luôn được khuyến khích, PLS-SEM kết hợp với bootstrapping vẫn có thể cho ra kết quả đáng tin cậy với cỡ mẫu tương đối nhỏ so với CB-SEM (AMOS).
- Cung cấp các chỉ số kiểm định quan trọng: Cung cấp đầy đủ bộ ba T-value, P-value và Khoảng tin cậy (Confidence Intervals), giúp nhà nghiên cứu có nhiều góc nhìn để kết luận về giả thuyết của mình.
- Tăng tính vững chắc của kết quả: Bằng cách tạo ra hàng ngàn mẫu con, bootstrapping giúp ước lượng sai số chuẩn một cách ổn định và đáng tin cậy hơn, làm tăng độ vững chắc (robustness) cho các kết luận nghiên cứu.
Các bước tiến hành kiểm định Bootstrapping trên SmartPLS 4
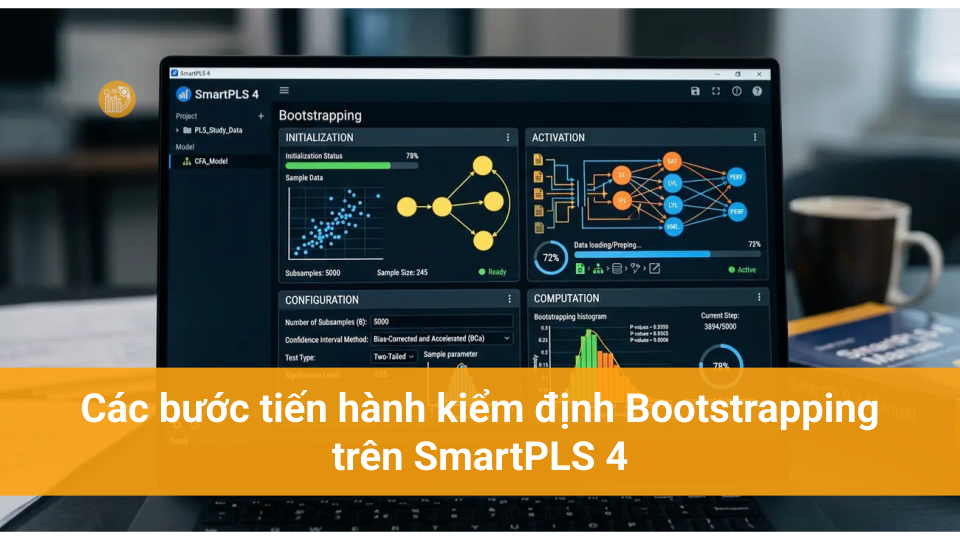
Bước 1: Khởi tạo mô hình phân tích
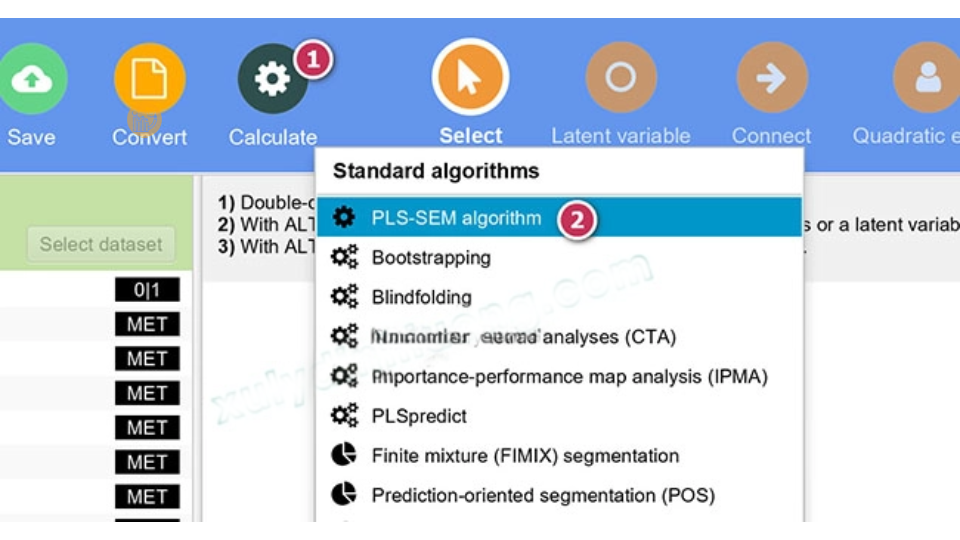
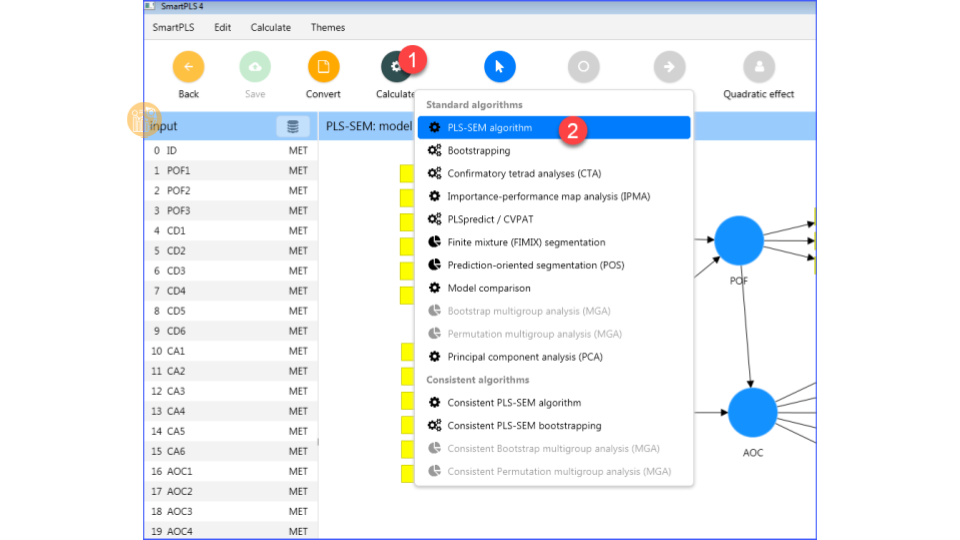
Bước 2: Kích hoạt Bootstrapping
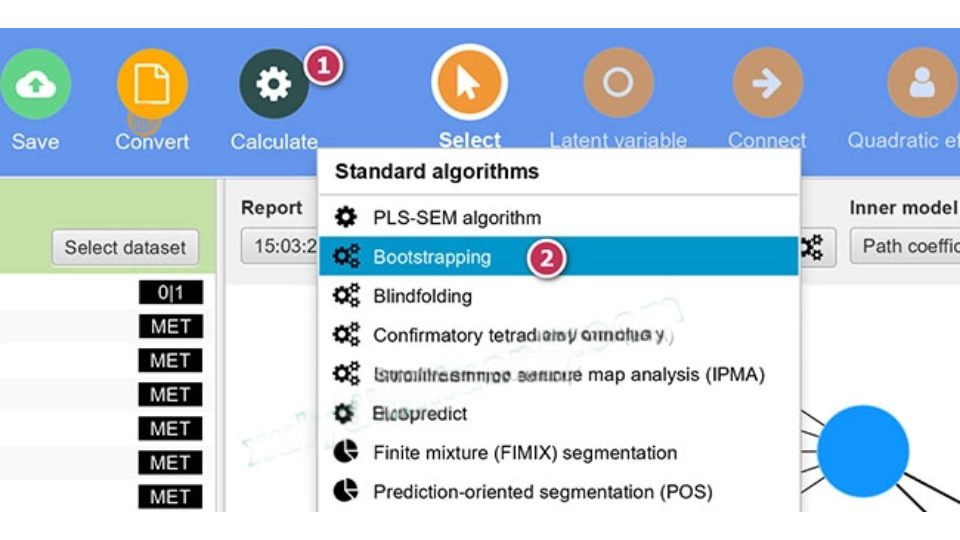
Bước 3: Thiết lập các thông số cài đặt
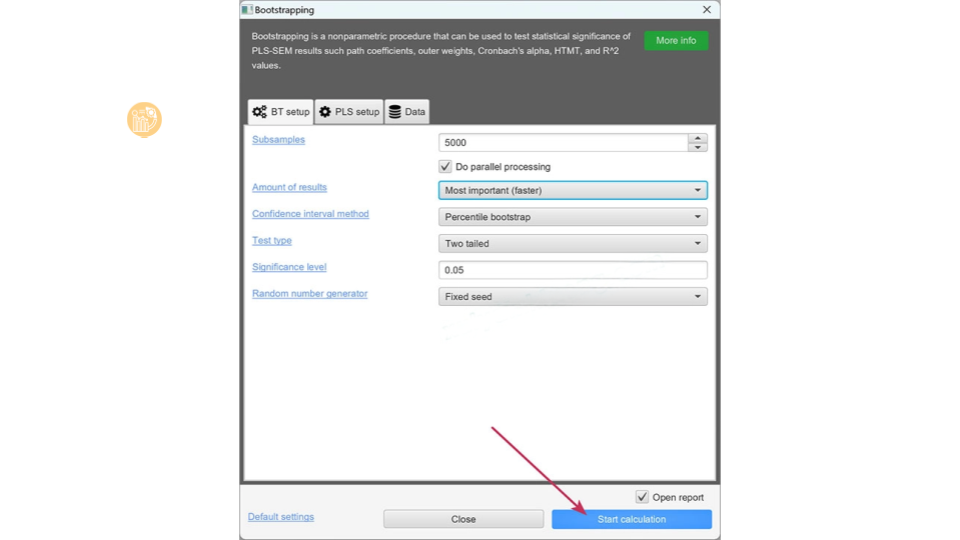
- Subsamples: Đây là số lượng mẫu bootstrap con sẽ được tạo ra. Theo khuyến nghị mới nhất của Hair và cộng sự (2022), bạn nên đặt là
10,000cho báo cáo kết quả cuối cùng để đảm bảo sai số chuẩn hội tụ và ổn định. Khi chạy thử, bạn có thể đặt1,000cho nhanh. - Test Type: Chọn
Two-tailed(Kiểm định hai phía). Đây là lựa chọn tiêu chuẩn và an toàn nhất cho hầu hết các nghiên cứu khoa học xã hội, vì nó cho phép kiểm định cả tác động dương và âm. - Significance level: Đặt là
0.05. Điều này tương ứng với mức ý nghĩa 5% và khoảng tin cậy 95%, là mức phổ biến nhất trong các nghiên cứu. - Confidence interval method: Chọn
Percentile Bootstrap. Đây là phương pháp mặc định, mạnh mẽ và ổn định trong hầu hết các trường hợp. - Random Number Generator (Seed): Chọn
Fixed seedvà nhập một con số bất kỳ (ví dụ: 12345). Đây là một cải tiến quan trọng giúp đảm bảo tính lặp lại (replicability) của nghiên cứu. Khi cố định “hạt giống” này, mỗi lần bạn chạy lại Bootstrapping SmartPLS trên cùng một bộ dữ liệu, kết quả sẽ giống hệt nhau.
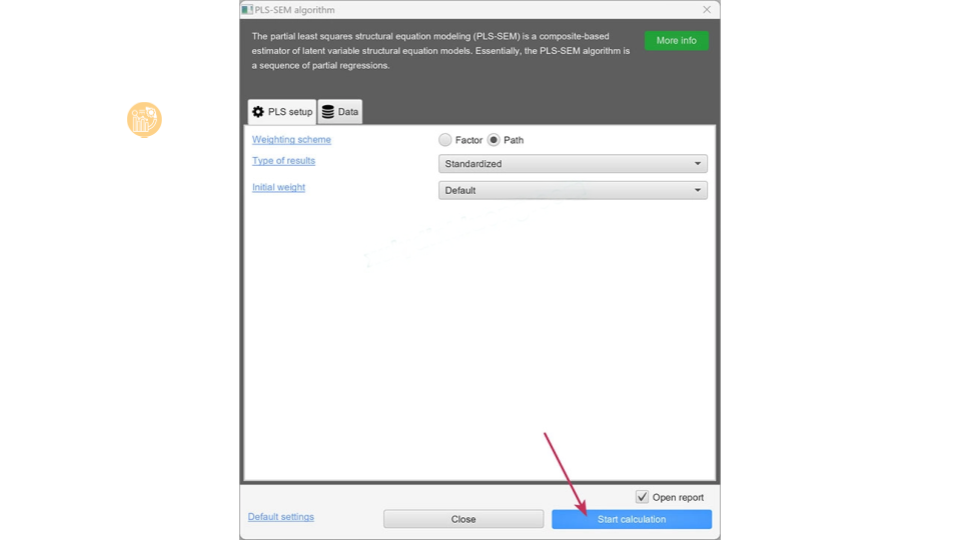
Bước 4: Bắt đầu quá trình tính toán
Cách diễn giải kết quả Bootstrapping
A. Phân tích Hệ số đường dẫn và Ý nghĩa Thống kê
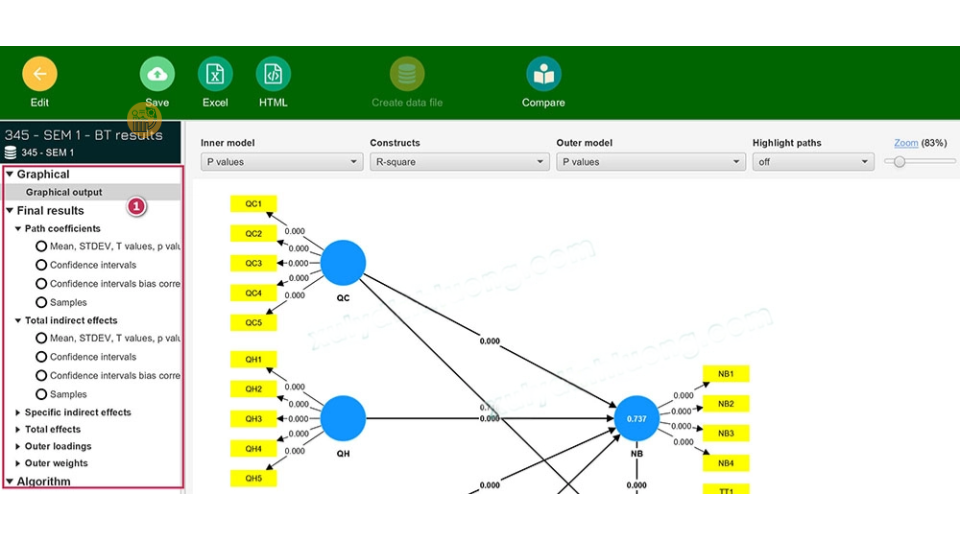
- P-value (Giá trị P): Đây là chỉ số trực quan nhất. Nếu P-value < 0.05, mối quan hệ đó có ý nghĩa thống kê ở mức ý nghĩa 5%. Nếu P-value < 0.01, nó có ý nghĩa ở mức 1%. Nếu P-value < 0.001, nó có ý nghĩa ở mức 0.1%. Ngược lại, nếu P-value > 0.05, mối quan hệ đó không có ý nghĩa thống kê.
- T-value (Giá trị T): Chỉ số này cung cấp cùng một kết luận như P-value. Với kiểm định hai phía ở mức ý nghĩa 5%, một mối quan hệ được coi là có ý nghĩa thống kê nếu giá trị tuyệt đối của T-value ≥ 1.96. Tương tự, ngưỡng cho mức ý nghĩa 1% là 2.58 và mức 10% là 1.65.
B. Đánh giá Khoảng tin cậy Bootstrap
- Ví dụ 1 (Có ý nghĩa): Khoảng tin cậy là [0.212, 0.436]. Vì cả cận dưới (Lower Bound) và cận trên (Upper Bound) đều là số dương và không đi qua số 0, nên mối quan hệ này có ý nghĩa thống kê.
- Ví dụ 2 (Không có ý nghĩa): Khoảng tin cậy là [-0.041, 0.205]. Vì cận dưới là số âm và cận trên là số dương, khoảng này chứa giá trị 0. Do đó, mối quan hệ này không có ý nghĩa thống kê.
C. Các chỉ số chất lượng mô hình cần chú ý
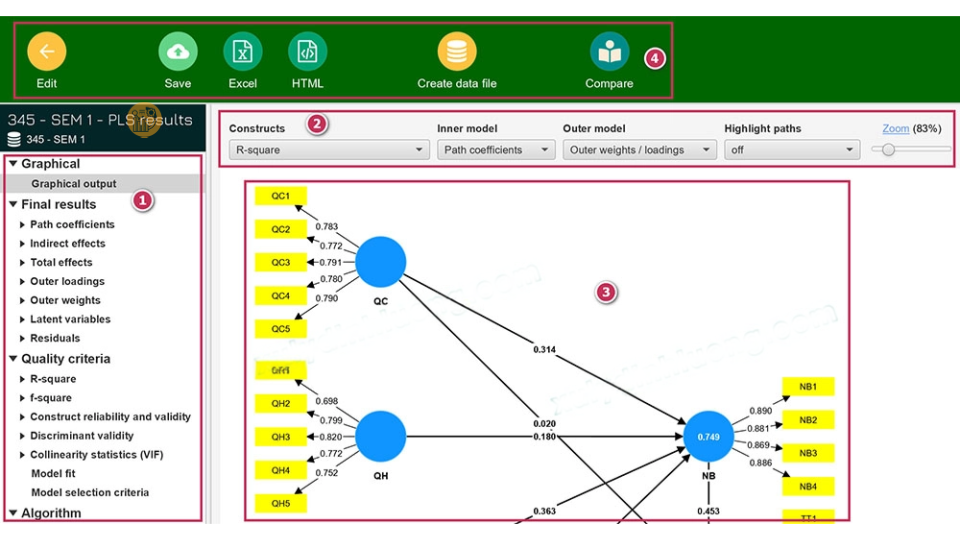
- R-square (R2): Hệ số xác định, cho biết mức độ các biến độc lập giải thích được sự thay đổi của biến phụ thuộc. Theo Hair và cộng sự, các mức đánh giá là 0.75 (mạnh), 0.50 (trung bình), 0.25 (yếu).
- f2 (Effect Size): Đo lường mức độ đóng góp của một biến độc lập cụ thể vào R² của biến phụ thuộc. Các mức đánh giá là 0.02 (nhỏ), 0.15 (vừa), và 0.35 (lớn).
- VIF (Variance Inflation Factor): Dùng để kiểm tra hiện tượng đa cộng tuyến. Nếu chỉ số VIF của các biến độc lập tác động lên cùng một biến phụ thuộc mà > 5 (một số tài liệu khắt khe hơn là > 3), mô hình của bạn có thể đang gặp vấn đề đa cộng tuyến.
Những vấn đề thường gặp và biện pháp khắc phục
Lỗi 1: Hệ số không có ý nghĩa thống kê
- Nguyên nhân & Cách khắc phục:
- Kiểm tra đa cộng tuyến: Quay lại kết quả PLS-SEM Algorithm, xem bảng “Collinearity Statistics (VIF)”. Nếu có chỉ số VIF > 5, các biến độc lập của bạn đang giải thích chồng chéo cho nhau, làm triệt tiêu ý nghĩa thống kê. Ví dụ thực tế: Một nghiên cứu về sự hài lòng của nhân viên có hai biến độc lập “Môi trường làm việc” và “Quan hệ đồng nghiệp” với VIF = 6.2. Hai biến này có tương quan quá cao. Giải pháp là có thể gộp chúng thành một biến bậc hai (second-order construct) gọi là “Môi trường xã hội tại nơi làm việc” để giảm đa cộng tuyến.
- Cỡ mẫu quá nhỏ: Mặc dù PLS-SEM linh hoạt, một tác động yếu đòi hỏi cỡ mẫu đủ lớn để có thể phát hiện được. Hãy xem xét tăng cỡ mẫu nếu có thể.
- Tác động gián tiếp: Có thể tác động trực tiếp không có ý nghĩa vì nó được truyền tải hoàn toàn qua một biến trung gian (full mediation). Hãy kiểm tra kết quả “Specific Indirect Effects” trong báo cáo Bootstrapping SmartPLS để xem xét khả năng này.
Lỗi 2: Kết quả “n/a” trong phân tích
- Nguyên nhân: Thường là do có biến quan sát với phương sai bằng 0 (zero variance) trong một mẫu bootstrap con nào đó. Điều này xảy ra khi tất cả các đáp viên trong mẫu con đó chọn cùng một câu trả lời cho một câu hỏi. Hoặc do cỡ mẫu quá nhỏ kết hợp với việc dùng biến giả (dummy variables).
- Cách khắc phục: Rà soát lại dữ liệu thô. Loại bỏ các biến quan sát có phương sai cực thấp hoặc các câu trả lời không có sự biến thiên. Tăng cỡ mẫu cũng là một giải pháp hiệu quả.
Lỗi 3: Kết quả thay đổi sau mỗi lần tính toán
- Nguyên nhân: Bạn đã chọn
Random seedtrong phần cài đặt. Điều này làm cho quá trình lấy mẫu ngẫu nhiên thay đổi mỗi lần chạy. - Cách khắc phục: Luôn chọn
Fixed seedvà nhập một con số cố định. Điều này đảm bảo 100% kết quả của bạn sẽ nhất quán và có thể tái lặp, một yêu cầu quan trọng của nghiên cứu khoa học.
Hướng dẫn trình bày kết quả nghiên cứu theo chuẩn hàn lâm
Các bước trình bày Mô hình đo lường
Trình bày Mô hình cấu trúc và Kiểm định giả thuyết
| Giả thuyết | Mối quan hệ | Hệ số Beta (β) | Sai số chuẩn (SE) | Giá trị T | Giá trị P | Khoảng tin cậy 95% | Kết luận |
|---|---|---|---|---|---|---|---|
| H1 | CLDV -> SYH | 0.451 | 0.072 | 6.264 | <0.001 | [0.310, 0.592] | Chấp nhận |
| H2 | GIA -> SYH | 0.102 | 0.068 | 1.500 | 0.134 | [-0.031, 0.236] | Bác bỏ |
| H3 | CLDV -> TGCT | 0.689 | 0.055 | 12.527 | <0.001 | [0.581, 0.797] | Chấp nhận |
“Nghiên cứu sử dụng kỹ thuật Bootstrapping SmartPLS với 10,000 mẫu tái lặp để kiểm định các giả thuyết đã đề xuất. Kết quả phân tích mô hình cấu trúc (trình bày tại Bảng X) cho thấy: Giả thuyết H1, cho rằng Chất lượng dịch vụ (CLDV) có tác động tích cực đến Sự hài lòng (SYH), được ủng hộ (β = 0.451, T = 6.264, P < 0.001). Khoảng tin cậy 95% [0.310, 0.592] không chứa giá trị 0, củng cố thêm cho kết luận này. Tuy nhiên, giả thuyết H2 về tác động của Giá cả (GIA) đến Sự hài lòng (SYH) đã bị bác bỏ do không có ý nghĩa thống kê (β = 0.102, T = 1.500, P = 0.134 > 0.05).”
Thông Tin Liên Hệ
- Hotline/Zalo: 0878.968.468
- Email: cs@xulysolieu.info
- Website: xulysolieu.info
Phân Tích Biến Trung Gian Trong AMOS
Việc kiểm định mối quan hệ nhân quả trong một bài nghiên cứu có biến trung gian không chỉ dừng lại ở việc xác định tác động trực tiếp. Một phân tích sâu sắc đòi hỏi phải làm rõ cơ chế mà biến độc lập ảnh hưởng đến biến phụ thuộc. Đây chính là lúc kỹ thuật phân tích biến trung gian phát huy vai trò quyết định, đặc biệt khi sử dụng phần mềm AMOS. Phương pháp luận hiện đại đã dịch chuyển từ các quy trình hồi quy từng bước của Baron & Kenny sang kỹ thuật Bootstrapping mạnh mẽ, mang lại kết quả chính xác và đáng tin cậy hơn.
Trong bài viết này, đội ngũ chuyên gia của xulysolieu.info sẽ cung cấp một hướng dẫn toàn diện, từ khái niệm nền tảng, các bước thực hành chi tiết, cách đọc kết quả, cho đến xử lý các lỗi thường gặp khi thực hiện phân tích biến trung gian trong AMOS. Mục tiêu là giúp các nhà nghiên cứu, học viên cao học và sinh viên tự tin áp dụng kỹ thuật này vào luận văn, luận án một cách chuyên nghiệp và hiệu quả.
Khái Niệm Về Biến Trung Gian Trong Nghiên Cứu Khoa Học
1. Biến Trung Gian Là Gì?
Biến trung gian trong nghiên cứu khoa học là gì? Nói một cách đơn giản, biến trung gian (Mediator Variable – M) là một yếu tố thứ ba, có vai trò giải thích hoặc làm cầu nối cho mối quan hệ giữa biến độc lập (Independent Variable – X) và biến phụ thuộc (Dependent Variable – Y). Theo định nghĩa kinh điển của Baron & Kenny (1986), biến trung gian lý giải “quá trình mà thông qua đó một biến độc lập tác động đến một biến phụ thuộc”. Thay vì chỉ trả lời câu hỏi “liệu X có ảnh hưởng đến Y không?”, biến trung gian giúp trả lời câu hỏi sâu hơn: “X ảnh hưởng đến Y BẰNG CÁCH NÀO?”.
Tầm quan trọng của việc xác định biến trung gian nằm ở chỗ nó giúp các nhà nghiên cứu khám phá sâu hơn về các cơ chế lý thuyết đằng sau các mối quan hệ quan sát được. Ví dụ, một chương trình đào tạo (X) có thể cải thiện hiệu suất công việc (Y). Tuy nhiên, cơ chế thực sự có thể là chương trình đào tạo làm tăng sự hài lòng trong công việc (M), và chính sự hài lòng này mới dẫn đến hiệu suất cao hơn. Việc xác định M giúp làm sáng tỏ toàn bộ chuỗi nhân quả, mang lại giá trị học thuật và thực tiễn cao hơn cho nghiên cứu.
2. Tại Sao Phải Kiểm Định Biến Trung Gian?
Việc kiểm định vai trò của biến trung gian là một bước không thể thiếu trong các nghiên cứu định lượng hiện đại, đặc biệt là khi xây dựng mô hình cấu trúc tuyến tính (SEM). Có hai lý do chính để thực hiện quy trình phân tích này.
Đầu tiên, nó giúp cải thiện độ tin cậy và giá trị của mô hình lý thuyết. Bằng cách xác minh sự tồn tại của một con đường gián tiếp, nhà nghiên cứu cung cấp bằng chứng thực nghiệm mạnh mẽ cho giả thuyết về cơ chế tác động. Điều này nâng cao tính hợp lệ bên trong (internal validity) của mô hình, cho thấy các mối quan hệ không phải là ngẫu nhiên mà tuân theo một logic nhân quả rõ ràng.
Thứ hai, phân tích biến trung gian cho phép chúng ta phân biệt giữa tác động trực tiếp và tác động gián tiếp. Việc nhận diện các con đường ảnh hưởng này là cực kỳ quan trọng trong ứng dụng thực tế. Nếu tác động gián tiếp là chủ đạo, các nhà quản lý có thể tập trung can thiệp vào biến trung gian để tạo ra thay đổi hiệu quả hơn, thay vì chỉ tác động vào biến độc lập ban đầu. Đây là một bước cốt lõi trong việc xây dựng các chiến lược và chính sách dựa trên bằng chứng.
Phân Tích Tác Động Trung Gian Với AMOS
1. Các Loại Tác Động Trung Gian
Khi thực hiện phân tích biến trung gian, kết quả sẽ được phân loại thành một trong ba trường hợp dựa trên ý nghĩa thống kê của tác động trực tiếp và gián tiếp:
- Trung gian toàn phần (Full Mediation): Đây là trường hợp tác động từ biến độc lập (X) đến biến phụ thuộc (Y) chỉ xảy ra duy nhất thông qua biến trung gian (M). Điều này có nghĩa là, khi đưa M vào mô hình, tác động trực tiếp từ X đến Y trở nên không có ý nghĩa thống kê (p-value ≥ 0.05), trong khi tác động gián tiếp (qua M) lại có ý nghĩa (p-value < 0.05).
- Trung gian một phần (Partial Mediation): Trong trường hợp này, tác động từ X đến Y diễn ra đồng thời theo cả hai con đường. Cả tác động trực tiếp (X → Y) và tác động gián tiếp (X → M → Y) đều có ý nghĩa thống kê (p-value < 0.05). Điều này cho thấy X vừa ảnh hưởng trực tiếp đến Y, vừa ảnh hưởng gián tiếp thông qua M. Đây là trường hợp phổ biến nhất trong các nghiên cứu khoa học xã hội.
- Không có vai trò trung gian (No Mediation): Xảy ra khi tác động gián tiếp từ X đến Y qua M không có ý nghĩa thống kê (p-value ≥ 0.05), bất kể tác động trực tiếp có ý nghĩa hay không. Điều này cho thấy M không đóng vai trò làm cầu nối trong mối quan hệ này.
2. Tác Động Trực Tiếp, Gián Tiếp Và Tác Động Tổng
Để hiểu rõ cách phân tích biến trung gian amos, việc nắm vững ba loại tác động là điều kiện tiên quyết. Trong một mô hình trung gian đơn giản, tổng ảnh hưởng của X lên Y được chia thành các thành phần sau:
- Tác động trực tiếp (Direct Effect – c’): Là phần ảnh hưởng của X lên Y mà không đi qua biến trung gian M. Nó được biểu thị bằng đường mũi tên trực tiếp từ X đến Y trong sơ đồ AMOS.
- Tác động gián tiếp (Indirect Effect – a × b): Là phần ảnh hưởng của X lên Y được truyền dẫn thông qua M. Nó được tính bằng tích của hệ số đường đi từ X đến M (ký hiệu là ‘a’) và hệ số đường đi từ M đến Y (ký hiệu là ‘b’). Đây là chỉ số quan trọng nhất để xác định sự tồn tại của hiệu ứng trung gian.
- Tác động tổng (Total Effect – c): Là tổng hợp của tác động trực tiếp và tác động gián tiếp. Nó đại diện cho toàn bộ ảnh hưởng của X lên Y. Công thức của nó là: Tác động tổng (c) = Tác động trực tiếp (c’) + Tác động gián tiếp (a × b).
Trong AMOS, các kết quả này được báo cáo rõ ràng trong các bảng “Standardized Direct/Indirect/Total Effects”, giúp nhà nghiên cứu dễ dàng đánh giá và kết luận về vai trò của biến trung gian.
Thực Hiện Phân Tích Trên AMOS
1. Thiết Lập Mô Hình Trung Gian Trong AMOS
Việc thiết lập mô hình là bước đầu tiên và cơ bản nhất trong quy trình phân tích biến trung gian. Quá trình này đòi hỏi sự chính xác để đảm bảo kết quả phân tích đáng tin cậy.
- Bước 1: Vẽ mô hình với X, M, và Y: Mở giao diện AMOS Graphics, sử dụng các công cụ để vẽ ba biến tiềm ẩn (hoặc biến quan sát) đại diện cho Biến độc lập (X), Biến trung gian (M) và Biến phụ thuộc (Y). Sau đó, vẽ các đường đi (path) thể hiện giả thuyết nghiên cứu: một đường từ X đến M, một đường từ M đến Y (thể hiện tác động gián tiếp), và một đường từ X đến Y (thể hiện tác động trực tiếp). Đừng quên thêm các phần dư (error term) cho các biến nội sinh (M và Y).
- Bước 2: Cài đặt đường đi và xác định các tham số cần thiết: Sau khi vẽ xong mô hình, bạn cần vào menu View -> Analysis Properties. Trong tab Output, hãy đảm bảo bạn đã tích chọn các ô sau:
- Standardized estimates: Để lấy hệ số đã chuẩn hóa, giúp so sánh mức độ tác động giữa các mối quan hệ.
- Indirect, direct & total effects: Đây là tùy chọn bắt buộc để AMOS tính toán và xuất ra ba loại tác động đã đề cập.
2. Kích Hoạt Kiểm Định Bootstrap
AMOS không tự động kiểm định ý nghĩa thống kê của tác động gián tiếp bằng phương pháp thông thường. Thay vào đó, kỹ thuật Bootstrapping được khuyến nghị và là tiêu chuẩn vàng hiện nay. Bootstrap là một phương pháp tái lấy mẫu phi tham số, giúp ước tính khoảng tin cậy và p-value cho tác động gián tiếp một cách chính xác mà không cần giả định về phân phối chuẩn.
- Cách thực hiện:
- Trong cửa sổ Analysis Properties, chuyển sang tab Bootstrap.
- Tích vào ô Perform Bootstrap.
- Tại mục Number of bootstrap samples, nhập số lượng mẫu tái lặp. Con số khuyến nghị là từ 1000 đến 5000. Phổ biến nhất là sử dụng 2000 hoặc 5000 để đảm bảo độ chính xác cao.
- Tích vào ô Bias-corrected confidence intervals và đặt mức tin cậy là 95%. Đây là phương pháp hiệu chỉnh sai lệch, cho kết quả ước tính khoảng tin cậy chính xác hơn.
- Sau khi hoàn tất cài đặt, đóng cửa sổ và nhấn nút “Calculate Estimates” để chạy phân tích.
Đọc Và Giải Thích Kết Quả Kiểm Định
1. Cách Đọc Hệ Số Tác Động Trong AMOS
Sau khi AMOS chạy xong, bạn vào View -> Text Output để xem kết quả. Các chỉ số quan trọng nằm trong mục Estimates -> Matrices.
Tại đây, bạn sẽ tìm thấy ba bảng quan trọng: Standardized Indirect Effects, Standardized Direct Effects, và Standardized Total Effects. Hãy tập trung vào bảng Standardized Indirect Effects. Bảng này trình bày hệ số tác động gián tiếp đã được chuẩn hóa. Ví dụ, giá trị ở ô giao nhau giữa biến độc lập (cột) và biến phụ thuộc (dòng) là 0.250. Điều này có nghĩa là khi biến độc lập tăng 1 đơn vị độ lệch chuẩn, biến phụ thuộc sẽ tăng 0.250 đơn vị độ lệch chuẩn thông qua vai trò của biến trung gian. Dấu của hệ số (+ hoặc -) cho biết chiều hướng của tác động.
2. Kiểm Tra Mức Ý Nghĩa Bằng Bootstrap
Để xác định xem tác động gián tiếp có ý nghĩa thống kê hay không, bạn cần xem kết quả từ Bootstrap. Trong cửa sổ Output, hãy điều hướng đến Estimates -> Bootstrap -> Confidence Intervals.
Tại đây, bạn có hai cách để đưa ra quyết định:
- Dựa vào p-value: Ở góc dưới bên trái của bảng kết quả, chọn mục Two-tailed Significance (BC). AMOS sẽ hiển thị cột p-value cho từng tác động.
- Quy tắc quyết định: Nếu p-value < 0.05, tác động gián tiếp có ý nghĩa thống kê. Ngược lại, nếu p-value ≥ 0.05, tác động gián tiếp không có ý nghĩa thống kê.
- Dựa vào khoảng tin cậy (Confidence Interval): Xem hai cột Lower và Upper của phương pháp Bias-corrected percentile method.
- Quy tắc quyết định: Nếu khoảng tin cậy 95% không chứa giá trị 0 (ví dụ: [0.085; 0.342] hoặc [-0.411; -0.097]), tác động gián tiếp có ý nghĩa thống kê. Nếu khoảng tin cậy này chứa số 0 (ví dụ: [-0.050; 0.120]), tác động đó không có ý nghĩa. Đây là phương pháp được ưa chuộng trong các báo cáo học thuật quốc tế.
Các Vấn Đề Thường Gặp Khi Phân Tích
1. Tác Động Không Đạt Ý Nghĩa
Một trong những vấn đề phổ biến nhất khi thực hiện phân tích biến trung gian là tác động gián tiếp không có ý nghĩa thống kê (p-value > 0.05). Có nhiều nguyên nhân có thể dẫn đến kết quả này.
- Nguyên nhân:
- Cỡ mẫu nhỏ: Kỹ thuật Bootstrap đòi hỏi một cỡ mẫu đủ lớn (thường N ≥ 200) để có đủ năng lực thống kê phát hiện các tác động.
- Đa cộng tuyến: Biến độc lập (X) và biến trung gian (M) có tương quan quá cao (ví dụ, r > 0.8), khiến chúng “tranh giành” và triệt tiêu phương sai giải thích cho biến phụ thuộc (Y).
- Giá trị ngoại lai (Outliers): Một vài quan sát dị biệt có thể làm lệch hướng đường hồi quy và làm suy yếu các mối quan hệ.
- Giải pháp:
- Cố gắng thu thập thêm dữ liệu để tăng cỡ mẫu.
- Kiểm tra hệ số VIF (Variance Inflation Factor) trong SPSS. Nếu VIF > 3, hãy xem xét loại bỏ biến hoặc gộp các biến quan sát có nội dung đo lường tương tự.
- Sử dụng khoảng cách Mahalanobis trong AMOS (Plugins -> Mahalanobis Distance) để xác định và loại bỏ các quan sát ngoại lai trước khi chạy mô hình chính thức.
2. Chỉ Số Phù Hợp Mô Hình Không Đạt
Kết quả phân tích biến trung gian chỉ đáng tin cậy khi mô hình tổng thể có độ phù hợp tốt với dữ liệu thị trường. Nếu các chỉ số như Chi-square/df, CFI, TLI, GFI, RMSEA không đạt ngưỡng khuyến nghị, bạn cần phải cải thiện mô hình trước.
- Cách khắc phục:
- Sử dụng Modification Indices (MI): Trong kết quả Output của AMOS, xem bảng Modification Indices. Tìm các cặp phần dư (e) của các biến quan sát thuộc cùng một nhân tố có chỉ số MI cao (thường > 10). Bạn có thể vẽ một đường hiệp phương sai (mũi tên hai chiều) giữa hai phần dư này để cải thiện độ phù hợp. Tuy nhiên, việc này chỉ nên được thực hiện khi có cơ sở lý thuyết vững chắc biện minh cho mối tương quan đó.
- Loại bỏ các biến không có ý nghĩa: Xem lại bảng hệ số hồi quy chuẩn hóa (Standardized Regression Weights). Nếu có biến quan sát nào có hệ số tải nhân tố (factor loading) quá thấp (ví dụ, < 0.5), nó đang đo lường kém cho khái niệm. Việc loại bỏ các biến này có thể làm “sạch” mô hình và cải thiện các chỉ số phù hợp.
Hướng Dẫn Trình Bày Kết Quả Trong Luận Văn
1. Tạo Bảng Tóm Tắt Kết Quả Phân Tích
Trình bày kết quả một cách rõ ràng và chuyên nghiệp là yếu tố quan trọng để thuyết phục hội đồng khoa học. Một bảng tóm tắt kết quả phân tích biến trung gian là không thể thiếu. Bảng này cần bao gồm các thông tin cốt lõi sau.
Mẫu bảng: Kết quả kiểm định tác động trung gian bằng Bootstrap
| Mối quan hệ tác động | Tác động trực tiếp (βdirect) | Tác động gián tiếp (βindirect) | Tổng tác động (βtotal) | Khoảng tin cậy Bootstrap 95% (BC) [Lower, Upper] | p-value (Bootstrap) | Kết luận |
|---|---|---|---|---|---|---|
| CLCV → HTCV → KQCV | 0.198* | 0.251** | 0.449 | [0.152; 0.358] | 0.001 | Trung gian một phần |
| DKLV → HTCV → KQCV | 0.075ns | 0.312** | 0.387 | [0.209; 0.421] | 0.000 | Trung gian toàn phần |
2. Viết Đoạn Giải Thích Kết Quả
Bên dưới bảng biểu, bạn cần một đoạn văn diễn giải chi tiết các con số. Đoạn văn này nên kết hợp các chỉ số từ bảng và giải thích ý nghĩa của chúng trong bối cảnh nghiên cứu cụ thể.
Cách viết:
“Để kiểm định giả thuyết Hx về vai trò trung gian của [Tên biến trung gian] trong mối quan hệ giữa [Tên biến độc lập] và [Tên biến phụ thuộc], nghiên cứu đã sử dụng kỹ thuật Bootstrapping với 5000 mẫu lặp và khoảng tin cậy 95% hiệu chỉnh sai lệch (Bias-corrected). Kết quả từ Bảng [số bảng] cho thấy tác động gián tiếp chuẩn hóa từ [Biến độc lập] đến [Biến phụ thuộc] thông qua [Biến trung gian] là có ý nghĩa thống kê (βindirect = 0.251, p = 0.001 < 0.05). Khoảng tin cậy 95% cho tác động này là [0.152; 0.358], không chứa giá trị 0, một lần nữa khẳng định sự tồn tại của mối quan hệ trung gian.
Đồng thời, tác động trực tiếp từ [Biến độc lập] đến [Biến phụ thuộc] cũng có ý nghĩa thống kê (βdirect = 0.198, p < 0.05). Do cả tác động trực tiếp và gián tiếp đều có ý nghĩa, có thể kết luận rằng [Biến trung gian] đóng vai trò trung gian một phần (partial mediation). Kết quả này hoàn toàn ủng hộ giả thuyết Hx đã đặt ra.”
Việc nắm vững kỹ thuật phân tích biến trung gian trong AMOS không chỉ là một yêu cầu kỹ năng, mà còn là một công cụ mạnh mẽ để nâng cao chiều sâu và giá trị học thuật của một công trình nghiên cứu. Nếu bạn gặp khó khăn trong quá trình xử lý dữ liệu, chạy mô hình SEM, hay diễn giải kết quả, đừng ngần ngại tìm đến sự hỗ trợ chuyên nghiệp. Đội ngũ của xulysolieu.info với kinh nghiệm dày dặn trong phân tích SPSS, AMOS, SmartPLS luôn sẵn sàng đồng hành cùng bạn để đảm bảo luận văn đạt được kết quả tốt nhất.
Hướng dẫn SmartPLS 4: Phân tích mô hình đo lường
Đánh giá mô hình đo lường là bước đi then chốt và bắt buộc khi phân tích mô hình cấu trúc tuyến tính bằng phương pháp PLS-SEM. Bước này đảm bảo rằng các thang đo bạn sử dụng thực sự đo lường chính xác các khái niệm lý thuyết trước khi đi vào kiểm định giả thuyết. Hướng dẫn SmartPLS 4 chi tiết này sẽ cung cấp cho bạn một quy trình toàn diện, từ chuẩn bị dữ liệu đến đọc và diễn giải kết quả, giúp bạn tự tin thực hiện phân tích cho khóa luận, luận văn và các dự án nghiên cứu hàn lâm.
Phân tích mô hình đo lường với SmartPLS 4 giúp xác định mức độ mà các biến tiềm ẩn (khái niệm trừu tượng) được giải thích một cách hiệu quả bởi các biến quan sát (các câu hỏi trong bảng khảo sát). Nắm vững kỹ thuật này là chìa khóa để đảm bảo kết quả nghiên cứu của bạn có độ tin cậy và giá trị cao.
1. SmartPLS 4 là gì và tầm quan trọng của nó trong phân tích PLS-SEM
Vậy SmartPLS 4 là gì? SmartPLS 4 là phiên bản mới nhất của phần mềm chuyên dụng cho việc phân tích Mô hình phương trình cấu trúc bằng phương pháp Bình phương tối thiểu riêng phần (Partial Least Squares Structural Equation Modeling – PLS-SEM). Với giao diện đồ họa trực quan và các thuật toán mạnh mẽ, nó đã trở thành công cụ không thể thiếu cho các nhà nghiên cứu trong nhiều lĩnh vực.
Trong nghiên cứu xã hội và kinh tế, SmartPLS 4 được ứng dụng rộng rãi để phân tích các mô hình phức tạp với nhiều biến tiềm ẩn và biến quan sát. Công cụ này đặc biệt hữu ích khi dữ liệu không đáp ứng các yêu cầu khắt khe về phân phối chuẩn, cỡ mẫu nhỏ, hoặc khi mô hình nghiên cứu bao gồm các thang đo dạng hình thành (formative). Từ marketing, quản trị nhân sự, tài chính đến tâm lý học, SmartPLS 4 cung cấp một giải pháp linh hoạt và hiệu quả.
Lợi ích chính của việc sử dụng SmartPLS 4 trong phân tích mô hình đo lường nằm ở khả năng đánh giá đồng thời độ tin cậy và tính hợp lệ của thang đo một cách nhanh chóng. Nó cho phép nhà nghiên cứu kiểm tra các chỉ số quan trọng như hệ số tải (outer loadings), độ tin cậy tổng hợp (CR), phương sai trích trung bình (AVE) và tỷ số HTMT. Nhờ đó, bạn có thể dễ dàng xác định và loại bỏ các biến quan sát yếu kém, đảm bảo mô hình đo lường đạt chuẩn trước khi tiến hành các phân tích sâu hơn.
2. Các bước chuẩn bị dữ liệu trước khi sử dụng SmartPLS 4
Chất lượng của phân tích phụ thuộc hoàn toàn vào chất lượng dữ liệu đầu vào. Trước khi tìm hiểu cách chạy SmartPLS 4, việc chuẩn bị dữ liệu cẩn thận là bước không thể bỏ qua.
Định dạng dữ liệu phổ biến và được khuyến nghị cho SmartPLS 4 là .csv (Comma Separated Values) hoặc .xlsx (Excel). Định dạng .csv thường được ưu tiên vì tính tương thích cao và giảm thiểu lỗi định dạng. Hãy chắc chắn rằng file dữ liệu của bạn được cấu trúc rõ ràng: mỗi cột đại diện cho một biến quan sát (một câu hỏi trong bảng khảo sát) và mỗi hàng đại diện cho một người trả lời (một phiếu khảo sát). Tên biến nên được đặt ngắn gọn, không dấu, không có ký tự đặc biệt và không bắt đầu bằng số.
Yêu cầu về chất lượng dữ liệu cũng cần được chú trọng. Mặc dù PLS-SEM linh hoạt hơn với dữ liệu không có phân phối chuẩn, bạn vẫn cần kiểm tra và xử lý các giá trị thiếu (missing values). SmartPLS 4 cung cấp các tùy chọn xử lý giá trị thiếu như “Mean replacement” hoặc “Casewise deletion”, nhưng cách tốt nhất là bạn nên xử lý chúng ngay từ trong file gốc. Dữ liệu “sạch” sẽ cho ra kết quả phân tích chính xác và đáng tin cậy hơn.
Cuối cùng, việc lựa chọn biến quan sát phù hợp là yếu tố quyết định. Các biến quan sát (items) phải được xây dựng dựa trên một nền tảng lý thuyết vững chắc và phải phản ánh đúng bản chất của biến tiềm ẩn (construct) mà chúng đo lường. Một thang đo tốt cần có ít nhất 3 biến quan sát để đảm bảo tính định danh và độ tin cậy. Việc lựa chọn các biến quan sát không phù hợp có thể dẫn đến các vấn đề như hệ số tải thấp, giá trị hội tụ kém, làm ảnh hưởng đến toàn bộ kết quả phân tích.
3. Cách chạy SmartPLS 4: Từ khởi tạo đến phân tích mô hình
Khi dữ liệu đã sẵn sàng, bạn có thể bắt đầu quá trình phân tích. Dưới đây là hướng dẫn chi tiết cách chạy SMARTPLS 4.
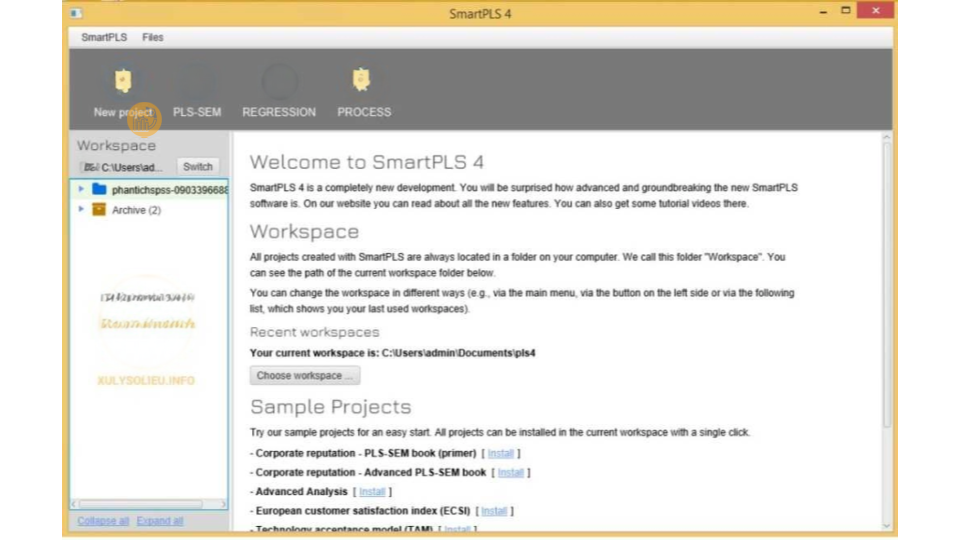
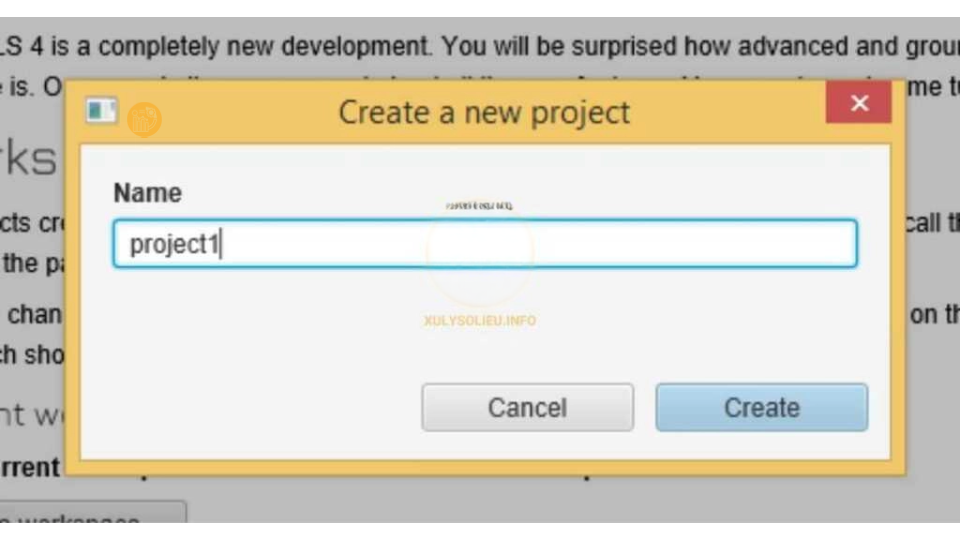
Bước đầu tiên là tạo một dự án mới và nhập dữ liệu. Mở phần mềm SmartPLS 4, nhấp vào “New Project”, đặt tên cho dự án của bạn, sau đó chọn “Import data file” để tải lên file dữ liệu đã chuẩn bị (định dạng .csv hoặc .xlsx). Phần mềm sẽ tự động phân tích và hiển thị một báo cáo tổng quan về dữ liệu của bạn, bao gồm số lượng quan sát, giá trị thiếu, và các thông số mô tả cơ bản.
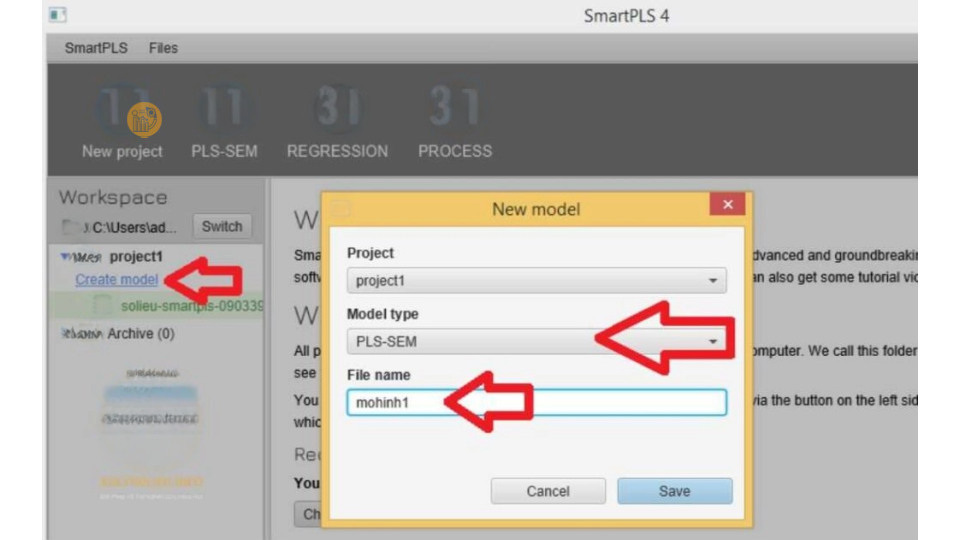
Tiếp theo, bạn sẽ xây dựng mô hình đo lường. Trong cửa sổ dự án, nhấp vào “Create model”, chọn loại mô hình là “PLS-SEM” và đặt tên. Màn hình vẽ mô hình (canvas) sẽ hiện ra. Bạn có thể tạo các biến tiềm ẩn (hình tròn màu xanh) bằng cách kéo công cụ “Latent Variable” từ thanh công cụ bên trái vào canvas. Sau đó, kéo các biến quan sát tương ứng từ danh sách dữ liệu bên trái và thả vào biến tiềm ẩn mà chúng đo lường. SmartPLS 4 sẽ tự động tạo các liên kết.
Một lưu ý quan trọng là chọn đúng loại mô hình đo lường. Mặc định, SmartPLS 4 sẽ tạo mô hình phản ánh (reflective), với các mũi tên đi từ biến tiềm ẩn ra các biến quan sát. Nếu nghiên cứu của bạn yêu cầu mô hình hình thành (formative), bạn chỉ cần nhấp chuột phải vào biến tiềm ẩn và chọn “Invert measurement model”. Các mũi tên sẽ đảo chiều, đi từ các biến quan sát vào biến tiềm ẩn, thể hiện đúng bản chất của mô hình hình thành.
4. Phân tích mô hình đo lường: Từ phản ánh đến hình thành
Việc lựa chọn giữa mô hình phản ánh và hình thành phụ thuộc hoàn toàn vào bản chất lý thuyết của khái niệm bạn đang nghiên cứu.
Mô hình phản ánh (Reflective Model) là loại phổ biến nhất trong nghiên cứu khoa học xã hội. Trong mô hình này, biến tiềm ẩn được coi là nguyên nhân, và các biến quan sát là biểu hiện hoặc “phản ánh” của biến tiềm ẩn đó. Các biến quan sát trong mô hình này có tương quan cao với nhau và về lý thuyết có thể thay thế cho nhau. Ví dụ, “Sự hài lòng của nhân viên” có thể được phản ánh qua các chỉ báo như “Hài lòng với công việc”, “Hài lòng với lương”, và “Hài lòng với đồng nghiệp”. Nếu loại bỏ một chỉ báo, ý nghĩa cốt lõi của “Sự hài lòng” vẫn không thay đổi.
Ngược lại, trong mô hình hình thành (Formative Model), các biến quan sát là những thành phần “hình thành” nên biến tiềm ẩn. Chúng là nguyên nhân, và biến tiềm ẩn là kết quả. Các biến quan sát trong mô hình này không nhất thiết phải tương quan với nhau và không thể thay thế cho nhau. Ví dụ, “Năng lực cạnh tranh của doanh nghiệp” được hình thành từ các yếu tố như “Năng lực marketing”, “Năng lực tài chính”, và “Năng lực sản xuất”. Việc loại bỏ bất kỳ yếu tố nào cũng sẽ làm thay đổi bản chất và ý nghĩa của “Năng lực cạnh tranh”.
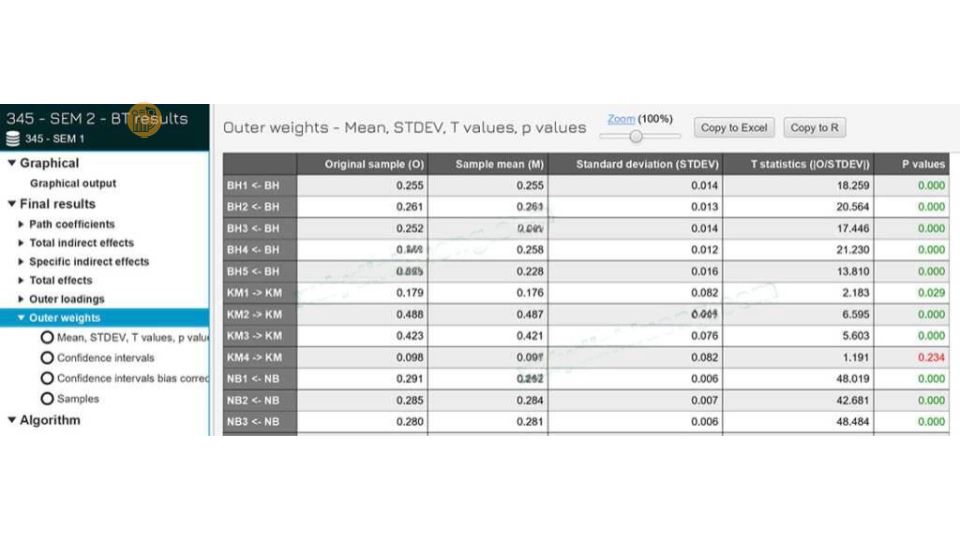
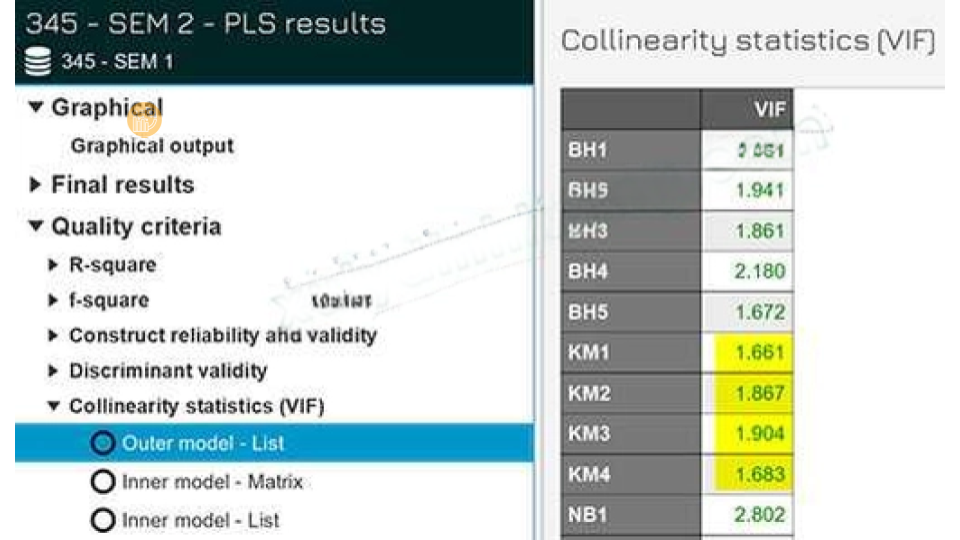
Các tiêu chuẩn kiểm tra hiệu lực và độ tin cậy cho hai loại mô hình này hoàn toàn khác nhau. Đối với mô hình phản ánh, chúng ta tập trung vào độ tin cậy nội tại (Cronbach’s Alpha, CR), tính hội tụ (AVE), và tính phân biệt (HTMT). Trong khi đó, đối với mô hình hình thành, các tiêu chuẩn quan trọng là kiểm tra đa cộng tuyến giữa các biến quan sát (chỉ số VIF) và đánh giá ý nghĩa thống kê của các trọng số ngoài (Outer Weights) thông qua kỹ thuật SmartPLS 4 bootstrapping. Nhầm lẫn giữa hai loại mô hình này là một trong những sai lầm nghiêm trọng nhất trong phân tích PLS-SEM.
5. Đánh giá chất lượng mô hình đo lường trên SmartPLS 4
Sau khi chạy thuật toán “PLS-SEM Algorithm”, bạn cần đánh giá chất lượng mô hình đo lường dựa trên các chỉ số mà phần mềm cung cấp.
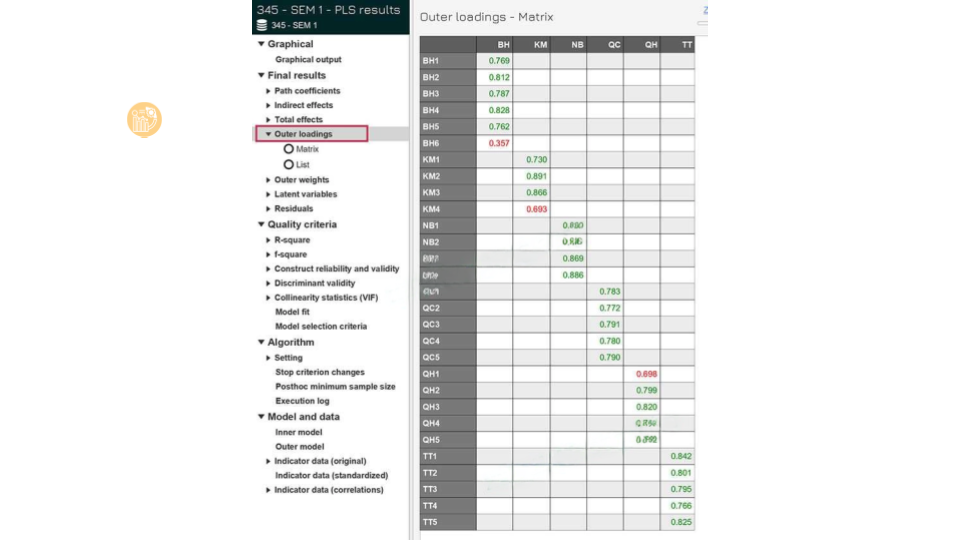
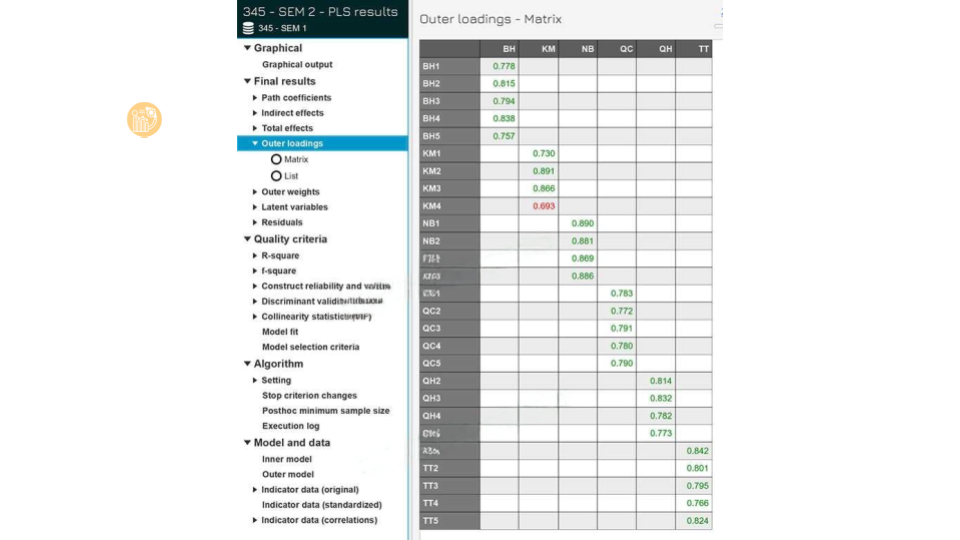
1.1 Chất lượng biến quan sát thang đo kết quả
1.2 Chất lượng biến quan sát thang đo nguyên nhân
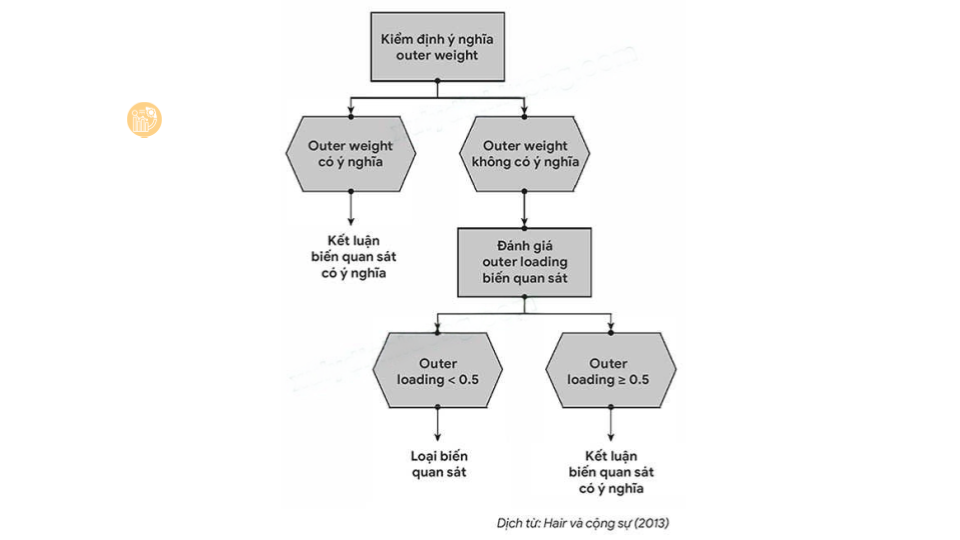
2.1 Độ tin cậy thang đo kết quả
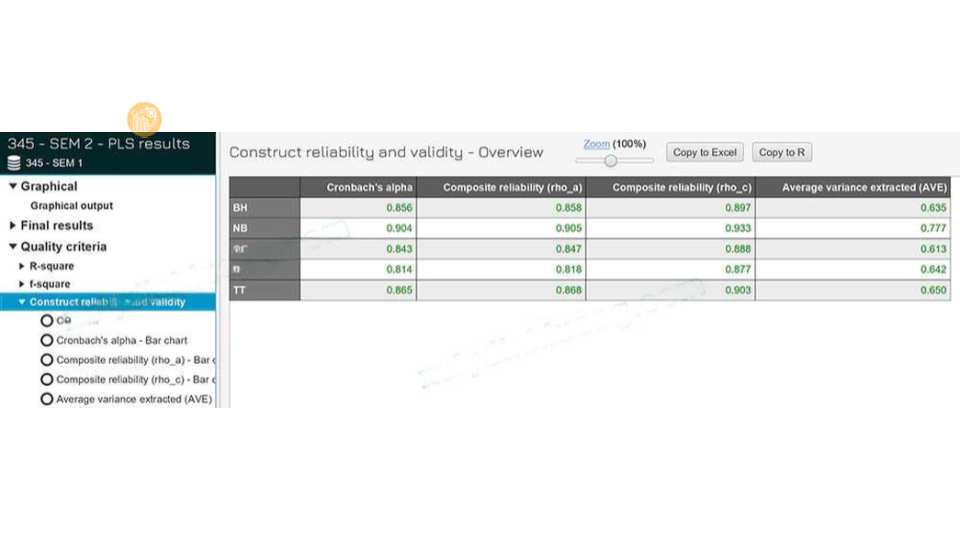
Đầu tiên là phân tích chỉ số tải ngoài (Outer Loadings) và hệ số tin cậy tổng hợp (Composite Reliability – CR). Outer Loadings thể hiện mức độ liên kết của từng biến quan sát với biến tiềm ẩn của nó. Theo Hair và cộng sự (2017), một biến quan sát có ý nghĩa khi Outer Loading ≥ 0.708. Chỉ số CR (trong SmartPLS 4 là rho_c) đo lường độ tin cậy nhất quán nội bộ của một thang đo, và giá trị này cần đạt từ 0.7 trở lên.
3.2 Tính hội tụ thang đo nguyên nhân
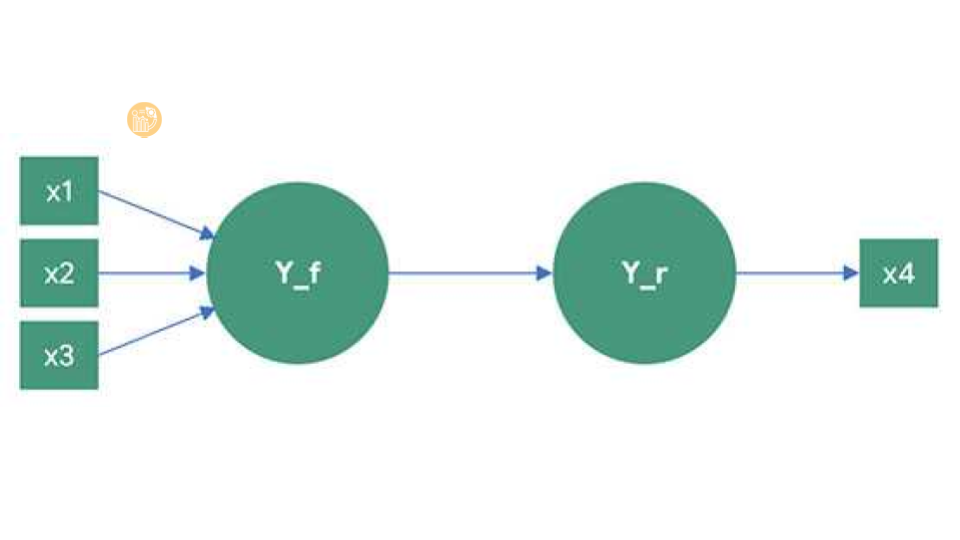
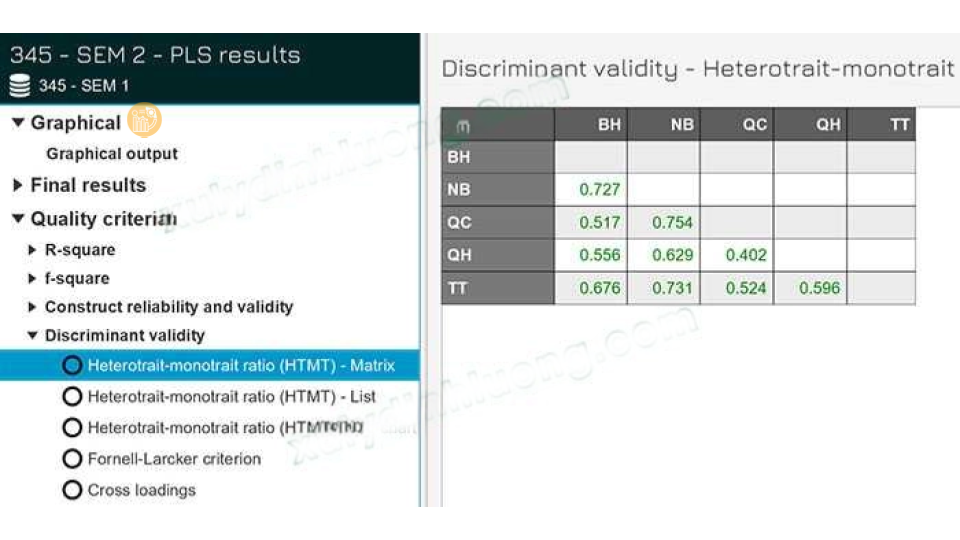
Tiếp theo là đánh giá tính hội tụ (Convergent Validity) và tính phân biệt (Discriminant Validity). Tính hội tụ được đánh giá thông qua Phương sai trích trung bình (Average Variance Extracted – AVE). Chỉ số AVE phải lớn hơn hoặc bằng 0.5, điều này có nghĩa là biến tiềm ẩn giải thích được ít nhất 50% phương sai của các biến quan sát cấu thành nó. Tính phân biệt đảm bảo rằng một khái niệm là khác biệt so với các khái niệm khác trong mô hình. Tiêu chuẩn hiện đại và khắt khe nhất để đánh giá là tỷ số HTMT (Heterotrait-Monotrait Ratio), với giá trị yêu cầu phải nhỏ hơn 0.85 hoặc 0.90 tùy thuộc vào bối cảnh nghiên cứu.
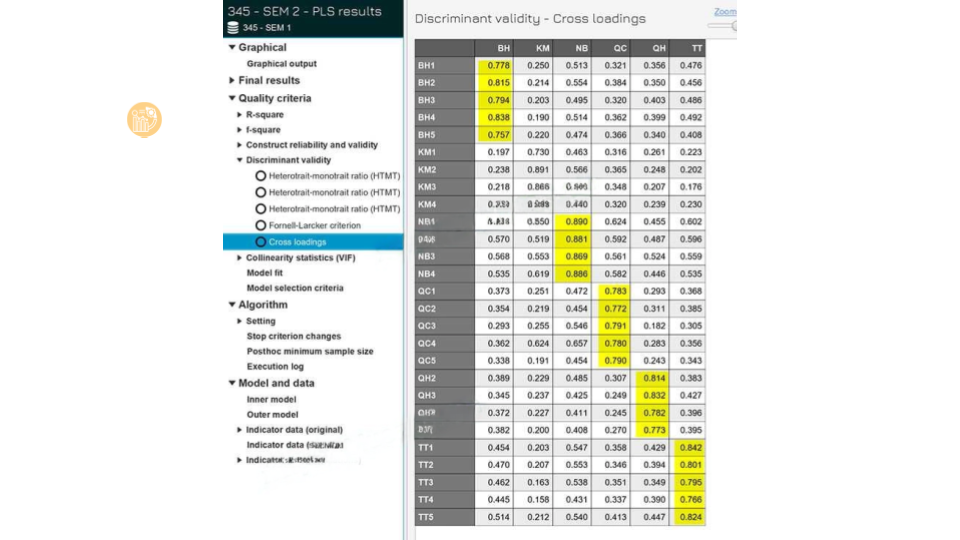
a. Đánh giá tính phân biệt bằng hệ số Cross-loading
b. Đánh giá tính phân biệt bằng bảng HTMT
5.2 Tính cộng tuyến biến quan sát thang đo nguyên nhân
Cuối cùng, kết quả kiểm định Bootstrapping là cực kỳ quan trọng. Để có được kết quả này, bạn cần chạy thuật toán SmartPLS 4 Bootstrapping (với số lần lặp lại mẫu tối thiểu là 5,000). Kỹ thuật này giúp xác định ý nghĩa thống kê (p-value) của các hệ số trong mô hình, bao gồm Outer Loadings và các hệ số đường dẫn (Path Coefficients). Cách đọc kết quả SMARTPLS 4 từ bootstrapping rất đơn giản: nếu p-value < 0.05, thì hệ số đó có ý nghĩa thống kê ở mức tin cậy 95%. Bootstrapping cũng cung cấp khoảng tin cậy cho chỉ số HTMT, giúp khẳng định tính phân biệt một cách chắc chắn hơn.
6. Hướng dẫn đọc kết quả phân tích mô hình đo lường
Hiểu rõ cách đọc kết quả SMARTPLS 4 là kỹ năng cốt lõi để diễn giải và báo cáo nghiên cứu.
Ý nghĩa của các chỉ số đánh giá như AVE và HTMT cần được nắm vững. Như đã đề cập, AVE ≥ 0.5 cho thấy các biến quan sát hội tụ tốt về cùng một khái niệm. HTMT < 0.90 (hoặc 0.85) là bằng chứng mạnh mẽ cho thấy các khái niệm bạn đo lường là khác biệt, không bị trùng lặp về mặt ý nghĩa. Khi viết báo cáo, bạn cần trình bày các bảng kết quả này và nhận xét rằng các tiêu chuẩn đều được đáp ứng, qua đó khẳng định mô hình đo lường của bạn là hợp lệ và đáng tin cậy.
Vậy phải làm gì khi có các biến không đạt yêu cầu? Ví dụ, nếu một biến quan sát có Outer Loading thấp (ví dụ < 0.4), bạn nên loại bỏ nó ngay lập tức. Nếu Outer Loading nằm trong khoảng từ 0.4 đến 0.7, bạn cần xem xét cẩn thận. Hãy thử xóa biến đó và chạy lại phân tích. Nếu việc xóa biến này giúp cải thiện đáng kể chỉ số CR và AVE của thang đo (ví dụ, giúp AVE vượt ngưỡng 0.5), thì quyết định xóa là hợp lý. Nếu không, bạn có thể giữ lại biến đó nếu nó có ý nghĩa quan trọng về mặt lý thuyết.
Trong bảng kết quả, bạn cũng cần chú ý đến các hệ số p-value và R². Hệ số p-value (từ kết quả SmartPLS 4 bootstrapping) cho bạn biết mối quan hệ đó có ý nghĩa thống kê hay không. Hệ số R² (R Square) cho biết mức độ biến thiên của một biến phụ thuộc được giải thích bởi các biến độc lập trong mô hình. Các giá trị R² là 0.25, 0.50 và 0.75 tương ứng với mức độ giải thích yếu, trung bình và mạnh. Hiểu rõ các chỉ số này giúp bạn có một cái nhìn toàn diện về cả mô hình đo lường và mô hình cấu trúc.
7. Mẹo xử lý khi kết quả không như mong đợi
Trong thực tế, hiếm khi nào dữ liệu của bạn hoàn hảo ngay từ lần chạy đầu tiên. Dưới đây là một số mẹo xử lý khi kết quả phân tích trên SmartPLS 4 không như kỳ vọng.
Khi gặp phải tình trạng Outer Loading thấp, hãy bình tĩnh xem xét. Nếu một biến quan sát có hệ số tải dưới 0.4, hãy loại bỏ nó. Nếu hệ số tải nằm trong khoảng [0.4, 0.7], hãy thử xóa biến đó và kiểm tra xem chỉ số AVE và CR có được cải thiện hay không. Nếu các chỉ số này đã đạt chuẩn, việc giữ lại biến đó để bảo toàn nội dung lý thuyết là hoàn toàn có thể chấp nhận được, đặc biệt trong các nghiên cứu khám phá.
Trường hợp AVE không đạt yêu cầu (< 0.5) cũng rất phổ biến. Hướng giải quyết là xác định và loại bỏ dần các biến quan sát có Outer Loading thấp nhất trong thang đo đó. Sau mỗi lần loại bỏ, bạn cần chạy lại thuật toán PLS để xem chỉ số AVE đã được cải thiện và vượt ngưỡng 0.5 hay chưa. Hãy nhớ rằng, một thang đo cần có tối thiểu 2-3 biến quan sát để đảm bảo giá trị, vì vậy đừng loại bỏ quá nhiều.
Khi mô hình thất bại trong việc đáp ứng các tiêu chuẩn, ví dụ như vi phạm tính phân biệt (HTMT > 0.9), bạn có thể cần điều chỉnh lại mô hình. Một khả năng là hai khái niệm đang quá giống nhau, bạn có thể xem xét việc gộp chúng thành một khái niệm duy nhất. Hoặc, kiểm tra bảng cross-loadings để xác định các biến quan sát “gây nhiễu” (tải lên nhiều nhân tố cùng lúc) và loại bỏ chúng. Việc điều chỉnh mô hình cần dựa trên cả kết quả thống kê và cơ sở lý thuyết.
8. Liên kết tải SmartPLS 4 và thông tin bổ sung
Để bắt đầu hành trình phân tích dữ liệu của mình, bạn cần cài đặt phần mềm. Việc tìm kiếm link SmartPLS 4 Download rất đơn giản. Bạn có thể truy cập trực tiếp Trang chính thức SmartPLS GmbH để tải về phiên bản mới nhất. Họ cung cấp bản dùng thử miễn phí 30 ngày với đầy đủ tính năng, rất phù hợp cho sinh viên và nghiên cứu viên làm quen và thực hiện các dự án ngắn hạn.
Để nâng cao kỹ năng sử dụng SmartPLS 4, có rất nhiều tài nguyên học tập và tài liệu tham khảo chất lượng. Trang web của SmartPLS cung cấp các tài liệu hướng dẫn, video tutorials và một diễn đàn cộng đồng sôi nổi. Ngoài ra, cuốn sách “A Primer on Partial Least Squares Structural Equation Modeling (PLS-SEM)” của các tác giả Joseph F. Hair, Jr., G. Tomas M. Hult, Christian M. Ringle, và Marko Sarstedt là tài liệu gối đầu giường cho bất kỳ ai muốn đi sâu vào phương pháp này.
Bên cạnh đó, để nghiên cứu và phân tích của bạn đạt kết quả tốt nhất, bạn có thể cần đến sự hỗ trợ từ các chuyên gia. Các dịch vụ tư vấn thống kê, xử lý số liệu có thể giúp bạn giải quyết những vấn đề phức tạp như xử lý dữ liệu lỗi, khắc phục các chỉ số mô hình không đạt chuẩn, hay diễn giải các kết quả phức tạp. Đừng ngần ngại tìm kiếm sự giúp đỡ khi cần thiết để đảm bảo công trình nghiên cứu của bạn đạt chất lượng cao nhất.
Việc phân tích và đánh giá mô hình đo lường là một công đoạn đòi hỏi sự cẩn trọng và kiến thức chuyên môn. Hy vọng bài viết hướng dẫn chi tiết về SmartPLS 4 này đã cung cấp cho bạn những thông tin hữu ích. Tuy nhiên, nếu bạn gặp khó khăn trong quá trình xử lý dữ liệu, chạy mô hình trên các phần mềm như SPSS, AMOS, SmartPLS, hoặc cần tư vấn chuyên sâu cho luận văn, khóa luận của mình, đội ngũ chuyên gia của Xulysolieu.info luôn sẵn sàng hỗ trợ. Chúng tôi cung cấp các dịch vụ từ xử lý dữ liệu thô, phân tích thống kê, cho đến tư vấn và sửa lỗi mô hình, giúp bạn tự tin bảo vệ thành công nghiên cứu của mình.
Thông Tin Liên Hệ
- Hotline/Zalo: 0878.968.468
- Email: cs@xulysolieu.info
- Website: xulysolieu.info
Hướng dẫn đánh giá tính hội tụ trong SmartPLS 4
Hướng Dẫn Đánh Giá Tính Hội Tụ Trong SmartPLS 4
Định Nghĩa Tính Hội Tụ
Phương Pháp Đo Lường Tính Hội Tụ
Ngưỡng Chấp Nhận AVE
Quy Trình Đánh Giá Tính Phân Biệt Trong SmartPLS 4
Định Nghĩa Tính Phân Biệt
Các Phương Pháp Đánh Giá
1. Tiêu Chí Fornell và Larcker
2. Chỉ Số HTMT
Các Bước Thao Tác Trên SmartPLS 4 Để Kiểm Định Tính Hội Tụ và Phân Biệt

Bước 1: Khởi Động Thuật Toán PLS-SEM
- Mở mô hình nghiên cứu đã được vẽ hoàn chỉnh trên giao diện SmartPLS 4.
- Trên thanh công cụ, chọn Calculate → PLS-SEM algorithm.
- Trong cửa sổ cài đặt, bạn có thể giữ nguyên các thông số mặc định. Lựa chọn quan trọng là Weighting scheme nên được đặt là Path.
- Nhấn nút Start Calculation để phần mềm bắt đầu phân tích.
Bước 2: Đọc Kết Quả Mô Hình Đo Lường
- Để đánh giá tính hội tụ và độ tin cậy: Trong danh sách bên trái, chọn Quality Criteria → Construct Reliability and Validity. Bảng này sẽ hiển thị các chỉ số Cronbach’s Alpha, Composite Reliability (CR), và quan trọng nhất là AVE.
- Để đánh giá tính phân biệt: Chọn Quality Criteria → Discriminant Validity. Tại đây, bạn có thể chuyển đổi qua lại giữa các tab Fornell-Larcker Criterion và HTMT để xem kết quả theo cả hai phương pháp.
Bước 3: Thực Hiện Kiểm Định Bootstrap
- Quay trở lại mô hình, chọn Calculate → Bootstrapping.
- Trong cửa sổ cài đặt, hãy đặt số lần lặp lại mẫu Subsamples là 5000 để đảm bảo kết quả ổn định và đáng tin cậy.
- Nhấn Start Calculation. Báo cáo Bootstrap sẽ cung cấp các hệ số đường dẫn (Path Coefficients) và giá trị p-value tương ứng.
Cách Diễn Giải Các Chỉ Số Tính Hội Tụ và Phân Biệt

Nhóm Chỉ Số Đánh Giá Mô Hình Đo Lường
- Hệ số tải ngoài (Outer Loadings): Phải lớn hơn 0.708. Các chỉ báo có loading dưới 0.4 nên được loại bỏ ngay lập tức. Các chỉ báo có loading từ 0.4 đến 0.7 có thể được giữ lại nếu việc giữ lại chúng không làm ảnh hưởng xấu đến độ tin cậy tổng hợp và AVE.
- Cronbach’s Alpha: Thường được yêu cầu > 0.7, nhưng đây là chỉ số ít được tin dùng hơn trong PLS-SEM.
- Độ tin cậy tổng hợp (Composite Reliability – CR): Phải lớn hơn 0.7. Chỉ số này được ưu tiên hơn Cronbach’s Alpha vì nó không giả định các hệ số tải là bằng nhau.
- Phương sai trung bình được trích (AVE): Đây là chỉ số quyết định tính hội tụ. AVE phải lớn hơn 0.5.
Nhóm Chỉ Số Đánh Giá Mô Hình Cấu Trúc
- Hệ số xác định (R2): Cho biết mức độ các biến độc lập giải thích cho sự thay đổi của biến phụ thuộc. Các giá trị 0.25, 0.50, và 0.75 tương ứng với mức độ giải thích yếu, trung bình, và mạnh.
- Hệ số tác động (f2): Đánh giá tầm quan trọng của một biến độc lập cụ thể đối với một biến phụ thuộc. Các giá trị 0.02, 0.15, và 0.35 tương ứng với tác động nhỏ, vừa, và lớn.
- Giá trị p (p-value): Dùng để kiểm định giả thuyết. Nếu p < 0.05, giả thuyết được ủng hộ, tức là mối quan hệ có ý nghĩa thống kê.
Xử Lý Dữ Liệu Xấu Khi Kết Quả Không Đạt Kỳ Vọng
Trường Hợp Tính Hội Tụ Vi Phạm (AVE < 0.50)
- Nguyên nhân: Thường do một hoặc nhiều biến quan sát có hệ số tải ngoài (Outer Loading) quá thấp, kéo giá trị AVE trung bình xuống.
- Cách giải quyết:
- Vào bảng kết quả Outer Loadings.
- Xác định chỉ báo có hệ số tải thấp nhất trong nhân tố đang bị lỗi.
- Thực hiện loại bỏ chỉ báo này khỏi mô hình.
- Chạy lại thuật toán PLS-SEM và kiểm tra lại chỉ số AVE. Lặp lại quy trình này cho đến khi AVE ≥ 0.5. Lưu ý, chỉ nên xóa từng biến một và kiểm tra lại sau mỗi lần xóa.
Trường Hợp Tính Phân Biệt Vi Phạm (HTMT > 0.90)
- Nguyên nhân: Hai khái niệm quá giống nhau, hoặc các câu hỏi đo lường chúng bị trùng lặp về ngữ nghĩa, khiến người trả lời không phân biệt được.
- Cách giải quyết:
- Kiểm tra hệ số tải chéo (Cross-Loadings): Tìm những chỉ báo có hệ số tải lên một nhân tố “lạ” cao hơn so với nhân tố “nhà” của nó. Đây là những chỉ báo gây nhiễu và cần được xem xét loại bỏ.
- Gộp nhân tố: Nếu HTMT quá cao (ví dụ > 0.95) và về mặt lý thuyết hai khái niệm đó có thể gộp lại, hãy xem xét việc kết hợp chúng thành một nhân tố duy nhất.
- Xem lại lý thuyết: Đôi khi vấn đề nằm ở chính bộ câu hỏi. Bạn có thể cần phải điều chỉnh lại câu chữ hoặc loại bỏ những câu hỏi mơ hồ gây chồng lấn khái niệm.
Hướng Dẫn Trình Bày Kết Quả Trong Luận Văn
Cách Soạn Thảo Bảng Kết Quả
| Nhân tố | Mã hóa | Outer Loading | Cronbach’s Alpha | CR | AVE |
|---|---|---|---|---|---|
| Sự hài lòng | HL1 | 0.852 | 0.870 | 0.919 | 0.791 |
| HL2 | 0.910 | ||||
| HL3 | 0.905 | ||||
| Lòng trung thành | TT1 | 0.821 | 0.845 | 0.897 | 0.744 |
| TT2 | 0.899 | ||||
| TT3 | 0.887 |
Biện Luận Kết Quả
“Kết quả tại Bảng 1 cho thấy mô hình đo lường có chất lượng tốt. Tất cả các hệ số tải ngoài (Outer Loadings) đều lớn hơn 0.708. Các chỉ số Độ tin cậy tổng hợp (CR) đều nằm trong khoảng từ 0.897 đến 0.919, vượt xa ngưỡng yêu cầu 0.70. Đặc biệt, tính hội tụ của các thang đo được đảm bảo một cách xuất sắc khi chỉ số Phương sai trích trung bình (AVE) của tất cả các nhân tố đều lớn hơn 0.744, cao hơn nhiều so với mức tối thiểu 0.50 (Hock & Ringle, 2010). Điều này khẳng định các biến quan sát đều hội tụ tốt và đại diện cho khái niệm mà chúng đo lường.”
“Để kiểm định tính phân biệt, tác giả sử dụng chỉ số HTMT. Kết quả cho thấy giá trị HTMT cao nhất giữa các cặp khái niệm là 0.682 (giữa Sự hài lòng và Lòng trung thành). Vì tất cả các giá trị HTMT đều nhỏ hơn ngưỡng 0.85 theo Henseler và cộng sự (2015), có thể kết luận rằng các khái niệm trong mô hình nghiên cứu hoàn toàn đạt được tính phân biệt, đảm bảo sự khác biệt rõ rệt về mặt ý nghĩa giữa chúng.”
- Hotline/Zalo: 0878.968.468
- Email: cs@xulysolieu.info
- Website: xulysolieu.info
Hướng dẫn SmartPLS 4 cơ bản: Quy trình tạo vùng làm việc
Chắc chắn bạn sẽ cần một hướng dẫn SmartPLS 4 chi tiết để làm quen với phần mềm thống kê hàng đầu này, đặc biệt khi đây là công cụ không thể thiếu cho phương pháp mô hình hóa phương trình cấu trúc PLS-SEM. Nhiều nhà nghiên cứu, từ sinh viên đến nghiên cứu sinh, thường gặp lúng túng ngay từ những bước thiết lập ban đầu do cơ chế quản lý dự án khác biệt của SmartPLS 4. Bài viết này sẽ cung cấp một lộ trình rõ ràng, từ việc tạo vùng làm việc, nhập liệu, chạy mô hình, diễn giải kết quả cho đến cách trình bày chuyên nghiệp trong luận văn của bạn. Việc tuân thủ đúng quy trình trong hướng dẫn SmartPLS 4 này là chìa khóa để đảm bảo kết quả phân tích của bạn chính xác và đáng tin cậy.
SmartPLS 4 mang đến nhiều cải tiến vượt trội so với các phiên bản tiền nhiệm, không chỉ về giao diện người dùng mà còn tích hợp thêm nhiều phương pháp phân tích mạnh mẽ như CB-SEM, PROCESS, và hồi quy tuyến tính. Hãy cùng xulysolieu.info khám phá bộ hướng dẫn SmartPLS 4 toàn diện, giúp bạn tự tin làm chủ công cụ này cho nghiên cứu của mình.
Hướng dẫn cơ bản về SmartPLS 4: Thiết lập Workspace
Bước 1: Khởi tạo và chọn vùng làm việc trong SmartPLS 4
Khi bạn khởi động phần mềm lần đầu tiên, một thông báo sẽ yêu cầu bạn thiết lập Workspace. Đây là bước bắt buộc và quan trọng nhất để bắt đầu sử dụng SmartPLS.
- Nhấn vào nút “Choose workspace” hoặc “Select your first workspace” hiển thị trên màn hình chào mừng.
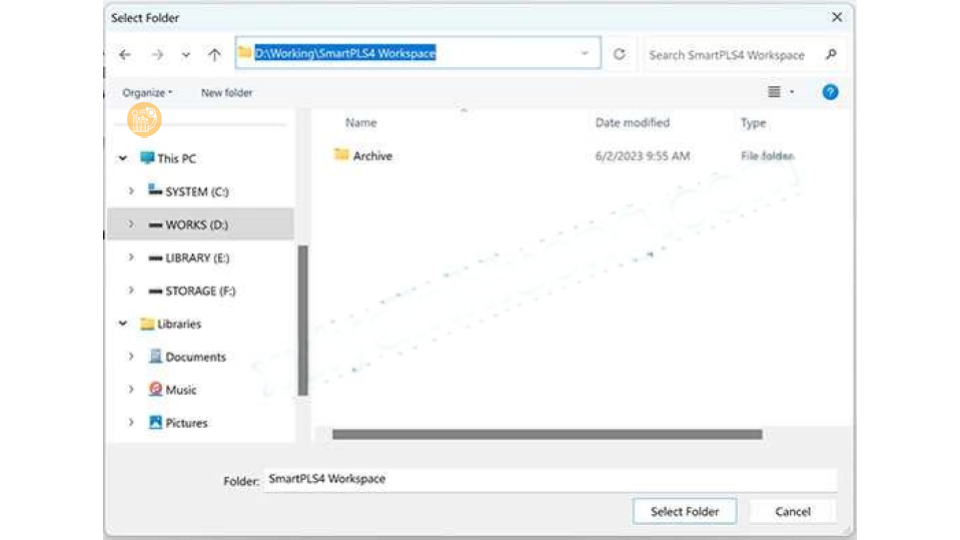
- Một cửa sổ duyệt file sẽ hiện ra. Nhiệm vụ của bạn là tạo một thư mục trống hoàn toàn trên máy tính để dành riêng cho SmartPLS. Ví dụ, bạn có thể tạo một thư mục tại đường dẫn
D:\Working\SmartPLS4_Workspace. Một lưu ý quan trọng là đường dẫn và tên thư mục không nên chứa ký tự tiếng Việt có dấu hoặc ký tự đặc biệt để tránh các lỗi không đáng có trong quá trình đọc và ghi file. - Sau khi chọn thư mục vừa tạo, nhấn “Select Folder”. SmartPLS 4 sẽ ghi nhớ thư mục này làm vùng làm việc mặc định cho tất cả các phiên làm việc sau này của bạn.
Bước 2: Tạo dự án mới trong SmartPLS 4
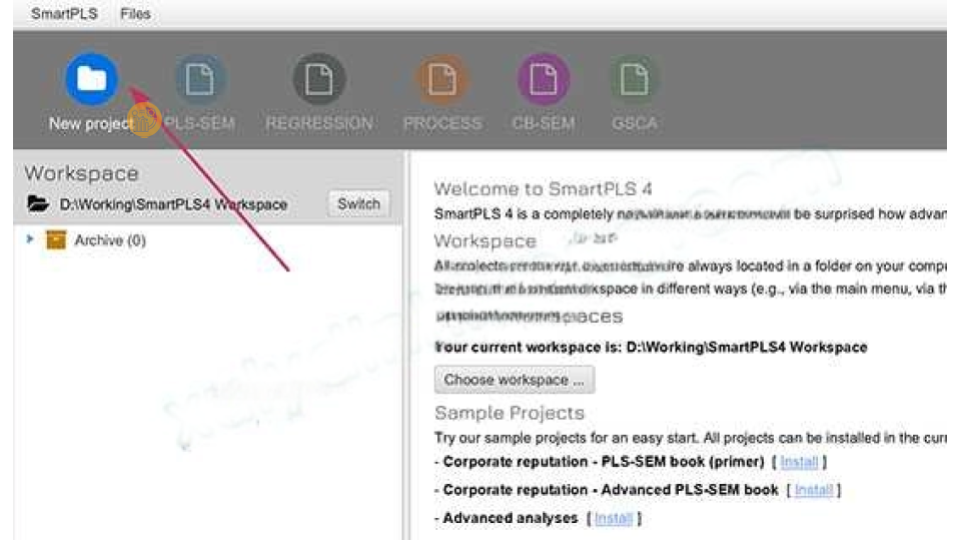
Mỗi nghiên cứu bạn thực hiện sẽ được quản lý trong một “Project” riêng biệt. Một Project chứa tất cả các thành phần liên quan như tệp dữ liệu, sơ đồ mô hình và các báo cáo kết quả.
- Trên thanh công cụ chính của phần mềm, tìm và nhấn vào nút “New Project”.
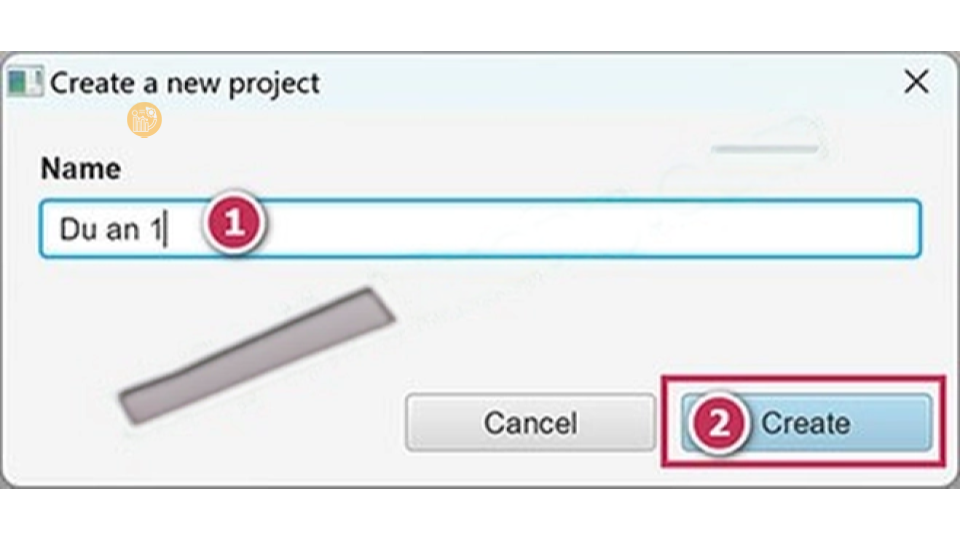
- Một hộp thoại sẽ xuất hiện, yêu cầu bạn nhập tên cho dự án. Hãy đặt một cái tên ngắn gọn, không dấu và gợi nhớ về đề tài của bạn (ví dụ:
Nghien_cuu_Hanh_vi_Tieu_dung_2024). - Nhấn “Create” để hoàn tất. Dự án mới của bạn sẽ ngay lập tức xuất hiện trong bảng điều khiển bên trái, sẵn sàng để bạn nhập dữ liệu và xây dựng mô hình. Đây là một bước đơn giản nhưng rất cần thiết trong hướng dẫn SmartPLS 4 này.
Bước 3: Cách nhập dữ liệu đầu vào vào SmartPLS 4
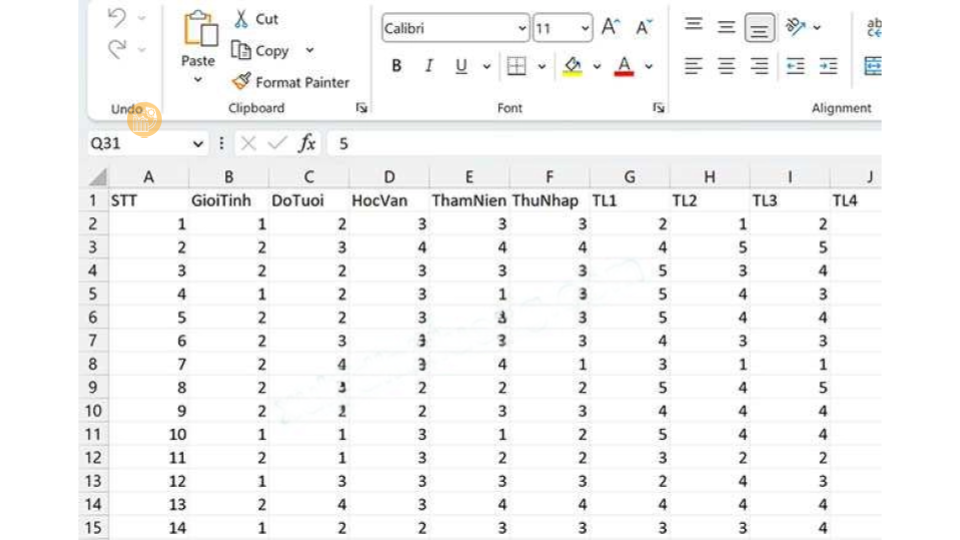
Sau khi tạo dự án, bước tiếp theo là đưa bộ dữ liệu khảo sát của bạn vào phần mềm. Đây là một trong những câu hỏi phổ biến nhất: cách nhập dữ liệu vào SmartPLS 4 sao cho đúng chuẩn.
- Nhấp đúp chuột vào tên dự án bạn vừa tạo. Hai tùy chọn chính sẽ hiện ra: “Import data file” và “Create model”. Hãy chọn “Import data file”.
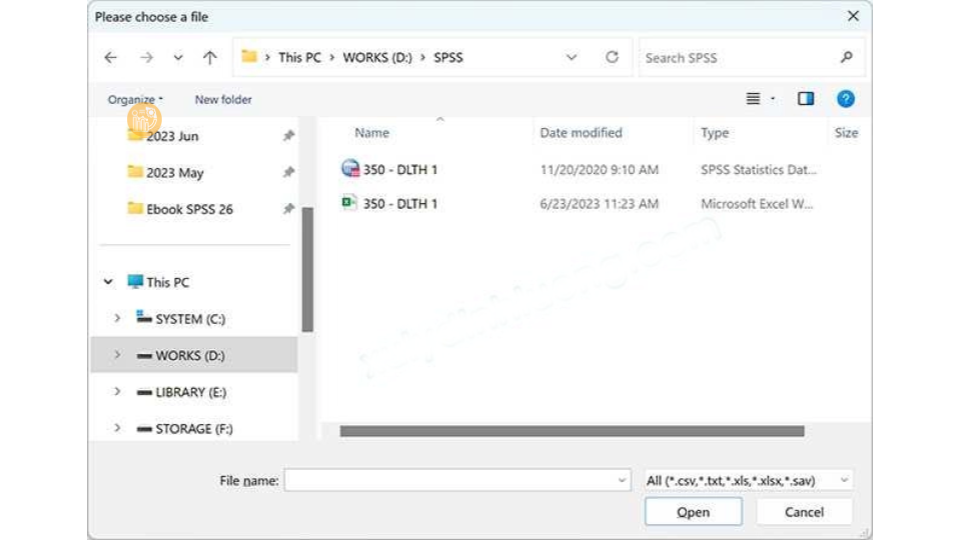
- Điều hướng đến thư mục chứa tệp dữ liệu của bạn. SmartPLS 4 rất linh hoạt và hỗ trợ nhiều định dạng phổ biến, bao gồm:
.sav: Định dạng gốc của phần mềm SPSS..xlsxhoặc.xls: Định dạng của Microsoft Excel..csv: Định dạng văn bản phân tách bằng dấu phẩy, có thể xuất ra từ Google Forms, Stata, hoặc R.
- Sau khi chọn tệp và nhấn “Open”, SmartPLS 4 sẽ hiển thị một bảng xem trước dữ liệu, bao gồm tên biến, số lượng giá trị thiếu (missing), thang đo, giá trị nhỏ nhất và lớn nhất. Hãy kiểm tra kỹ lưỡng bảng này để đảm bảo dữ liệu được nhận diện chính xác trước khi nhấn “Import”. Nếu không thấy bảng này, rất có thể tệp dữ liệu của bạn đang bị lỗi cấu trúc (ví dụ: chứa ký tự text thay vì số).
Bước 4: Biến đổi dữ liệu thành mô hình trong SmartPLS 4
Khi dữ liệu đã sẵn sàng, bạn có thể bắt đầu quá trình trực quan hóa mô hình nghiên cứu của mình.
- Trong cửa sổ dự án, nhấp vào tùy chọn “Create model”.
- Một hộp thoại cấu hình mô hình sẽ xuất hiện. Tại đây, bạn cần thực hiện hai lựa chọn quan trọng:
- Model Type: Chọn PLS-SEM, vì đây là phương pháp phân tích cốt lõi mà bài hướng dẫn SmartPLS 4 này tập trung vào.
- Model Name: Đặt tên cho sơ đồ mô hình của bạn (ví dụ:
So_do_Nghien_cuu).
- Nhấn “Save” để xác nhận. Màn hình sẽ chuyển sang giao diện vẽ (Canvas), nơi bạn có thể kéo thả các biến quan sát từ cột bên trái để tạo thành các biến tiềm ẩn và dùng công cụ “Connect” để vẽ các mối quan hệ giả thuyết.
Phương pháp chọn mô hình phân tích: PLS-SEM hay CB-SEM?
Một trong những quyết định học thuật quan trọng nhất là lựa chọn giữa hai phương pháp tiếp cận chính của mô hình phương trình cấu trúc (SEM): PLS-SEM (Partial Least Squares SEM) và CB-SEM (Covariance-Based SEM). Việc hiểu rõ SmartPLS 4 là gì và khi nào nên dùng nó sẽ quyết định tính hợp lệ cho toàn bộ nghiên cứu của bạn. Phiên bản SmartPLS 4 hỗ trợ cả hai, nhưng thế mạnh cốt lõi của nó vẫn là PLS-SEM.
Khi nào nên ứng dụng PLS-SEM?
Việc lựa chọn giữa PLS-SEM và CB-SEM phụ thuộc vào mục tiêu nghiên cứu, đặc tính dữ liệu và độ phức tạp của mô hình. PLS-SEM được ưu tiên sử dụng trong các trường hợp sau:
- Mục tiêu nghiên cứu là dự báo hoặc khám phá: Nếu mục tiêu của bạn là tối đa hóa khả năng giải thích phương sai của các biến phụ thuộc (tức là dự báo) hoặc khám phá các mối quan hệ mới để xây dựng lý thuyết, PLS-SEM là lựa chọn tối ưu. Ngược lại, CB-SEM (thường chạy trên AMOS) phù hợp hơn cho việc khẳng định hoặc kiểm chứng một lý thuyết đã có sẵn.
- Cỡ mẫu nhỏ: PLS-SEM hoạt động hiệu quả ngay cả với kích thước mẫu nhỏ (ví dụ, dưới 200), trong khi CB-SEM đòi devotion cỡ mẫu lớn để đảm bảo các ước lượng ổn định.
- Dữ liệu không tuân theo phân phối chuẩn: Đây là ưu điểm lớn nhất của PLS-SEM. Hầu hết các bộ dữ liệu khảo sát thực tế sử dụng thang đo Likert đều không đáp ứng giả định phân phối chuẩn đa biến nghiêm ngặt của CB-SEM. PLS-SEM là một phương pháp phi tham số, do đó nó không yêu cầu giả định này.
- Mô hình nghiên cứu phức tạp: PLS-SEM có khả năng xử lý các mô hình rất phức tạp với nhiều biến tiềm ẩn và biến quan sát mà không gặp các vấn đề về nhận dạng (identification issues) thường thấy trong CB-SEM.
Quá trình chạy kiểm định trên SmartPLS 4
Sau khi đã hoàn thành việc vẽ sơ đồ mô hình và tất cả các biến tiềm ẩn chuyển sang màu xanh dương (báo hiệu mô hình hợp lệ), bạn có thể bắt đầu quá trình phân tích. Quy trình này gồm hai bước chính được đề cập trong mọi hướng dẫn SmartPLS 4 chuyên sâu.
Bước 1: Thực hiện thuật toán PLS-SEM
Bước này nhằm mục đích ước lượng các tham số của mô hình đo lường và mô hình cấu trúc, bao gồm hệ số tải, trọng số, và các hệ số đường dẫn ban đầu.
- Từ thanh menu trên cùng, chọn Calculate và sau đó nhấn vào PLS-SEM algorithm.
- Một cửa sổ cấu hình sẽ hiện ra. Đối với hầu hết các nghiên cứu, bạn nên giữ nguyên các thiết lập mặc định (ví dụ: Weighting Scheme là “Path”, Max Iterations là 300).
- Nhấn nút Start calculation. Phần mềm sẽ thực thi thuật toán và hiển thị một báo cáo kết quả trực quan. Đây là nơi bạn sẽ đánh giá độ tin cậy và giá trị của các thang đo.
Bước 2: Thực hiện kiểm định lặp mẫu Bootstrapping
Để kiểm định ý nghĩa thống kê của các mối quan hệ trong mô hình (kiểm định giả thuyết), bạn cần sử dụng kỹ thuật Bootstrapping. Kỹ thuật này sẽ tạo ra một số lượng lớn các mẫu con từ mẫu gốc của bạn để ước tính sai số chuẩn, từ đó tính toán giá trị t và p-value.
- Quay trở lại sơ đồ mô hình, vào lại menu Calculate và lần này chọn Bootstrapping.
- Trong cửa sổ cấu hình, hãy thiết lập thông số quan trọng nhất: Subsamples. Theo khuyến nghị chuẩn hàn lâm của Hair và cộng sự (2017, 2021), bạn nên nhập
5000lần lặp để đảm bảo kết quả ổn định và đáng tin cậy. - Các thiết lập khác như phương pháp khoảng tin cậy (Confidence Interval Method) nên chọn “Bias-Corrected and Accelerated (BCa) Bootstrap” và loại kiểm định (Test Type) là “Two-tailed”.
- Nhấn Start calculation. Kết quả từ bước này sẽ cung cấp các giá trị p-value để bạn kết luận chấp nhận hay bác bỏ các giả thuyết nghiên cứu.
Cách diễn giải và phân tích kết quả đầu ra từ SmartPLS 4
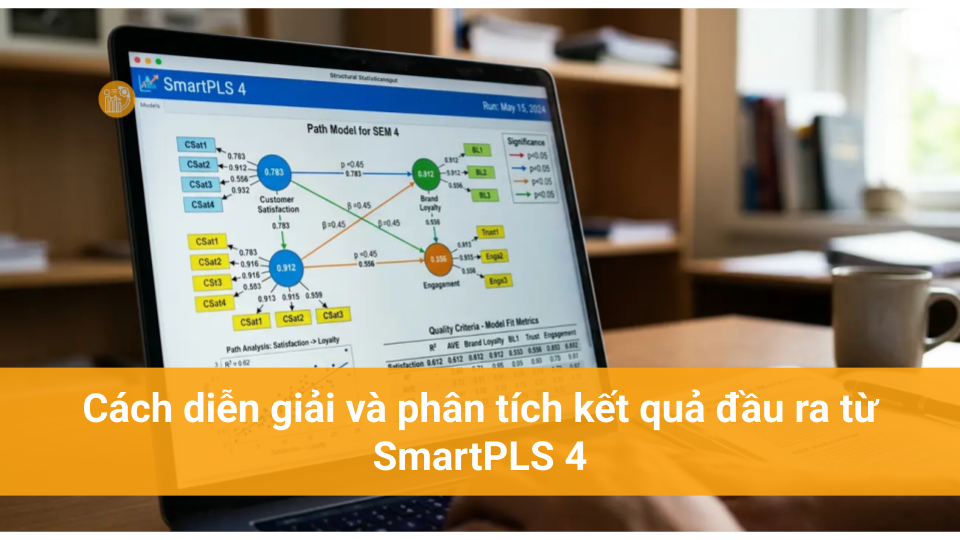
Việc đọc hiểu kết quả là kỹ năng cốt lõi trong hướng dẫn sử dụng SmartPLS 4. Quy trình diễn giải được chia thành hai giai đoạn rõ ràng: đánh giá mô hình đo lường trước, sau đó mới đến mô hình cấu trúc.
Đánh giá mô hình đo lường
Giai đoạn này tập trung vào việc xác minh rằng các thang đo bạn sử dụng là đáng tin cậy và hợp lệ.
- Độ tin cậy nhất quán nội tại (Internal Consistency Reliability): Bạn cần kiểm tra hai chỉ số chính. Cronbach’s Alpha và Composite Reliability (CR) đều phải lớn hơn hoặc bằng 0.7. Trong PLS-SEM, CR được coi là một chỉ số đo lường tốt hơn Cronbach’s Alpha.
- Giá trị hội tụ (Convergent Validity): Giá trị này được đảm bảo khi:
- Các Hệ số tải ngoài (Outer Loadings) của từng biến quan sát nên lớn hơn 0.708. Tuy nhiên, trong các nghiên cứu khám phá, các hệ số tải từ 0.5 trở lên vẫn có thể được chấp nhận.
- Phương sai trích trung bình (AVE – Average Variance Extracted) phải lớn hơn hoặc bằng 0.5. Chỉ số này cho biết biến tiềm ẩn giải thích được trung bình bao nhiêu phần trăm phương sai của các biến quan sát cấu thành nó. AVE >= 0.5 nghĩa là biến tiềm ẩn giải thích được trên 50% phương sai, một ngưỡng chấp nhận tốt.
Đánh giá mô hình cấu trúc
Sau khi xác nhận mô hình đo lường đạt yêu cầu, bạn mới chuyển sang đánh giá các mối quan hệ giữa các biến tiềm ẩn.
- Kiểm định giả thuyết (Path Coefficients): Trong báo cáo Bootstrapping, hãy xem xét cột Path Coefficients.
- Hệ số tác động (Original Sample – β): Cho biết mức độ và chiều hướng của tác động. Dấu dương là tác động cùng chiều, dấu âm là ngược chiều.
- Trị số p-value: Đây là chỉ số quyết định. Nếu p-value < 0.05, giả thuyết nghiên cứu được ủng hộ (có ý nghĩa thống kê). Nếu p-value >= 0.05, giả thuyết bị bác bỏ.
- Hệ số xác định (R2 – R Square): Chỉ số này cho biết mô hình giải thích được bao nhiêu phần trăm sự thay đổi của biến phụ thuộc. Ví dụ, R2 của biến “Lòng trung thành” là 0.652 có nghĩa là các biến độc lập trong mô hình giải thích được 65.2% sự biến thiên của Lòng trung thành.
Gỡ rối và xử lý các vấn đề thường gặp với kết quả
Trong thực tế, không phải lúc nào dữ liệu cũng hoàn hảo. Việc tuân thủ hướng dẫn SmartPLS 4 này sẽ giúp bạn xử lý các vấn đề phổ biến một cách khoa học.
Xử lý vấn đề về hệ số tải ngoài thấp
Khi một hoặc nhiều biến quan sát có hệ số tải ngoài (Outer Loading) quá thấp, độ tin cậy và giá trị của thang đo sẽ bị ảnh hưởng.
- Quy tắc xử lý: Nếu hệ số tải ngoài của một biến nhỏ hơn 0.4, bạn nên loại bỏ biến đó ra khỏi mô hình. Nếu hệ số tải nằm trong khoảng từ 0.4 đến 0.7, việc loại bỏ là tùy chọn. Hãy thử xóa biến đó và chạy lại thuật toán PLS-SEM. Nếu việc xóa giúp chỉ số Composite Reliability (CR) hoặc AVE của nhân tố tăng lên và vượt ngưỡng yêu cầu, quyết định xóa là hợp lý. Nếu không, bạn có thể giữ lại biến đó để bảo toàn nội dung của thang đo.
Xử lý vấn đề AVE không đạt yêu cầu
Khi một nhân tố có chỉ số AVE < 0.5, điều đó có nghĩa là giá trị hội tụ của thang đo chưa được đảm bảo.
- Phương pháp cải thiện: Cách xử lý phổ biến nhất là quay lại báo cáo “Outer Loadings”, xác định biến quan sát nào có hệ số tải ngoài thấp nhất trong nhân tố đó và loại bỏ nó. Sau khi loại bỏ, hãy chạy lại thuật toán để kiểm tra xem chỉ số AVE đã được cải thiện và vượt ngưỡng 0.5 hay chưa. Quá trình này có thể lặp lại cho đến khi đạt yêu cầu, nhưng hãy cẩn thận không loại bỏ quá nhiều biến làm mất đi ý nghĩa của thang đo.
Hướng dẫn trình bày kết quả nghiên cứu trong luận văn
Phần cuối cùng của hướng dẫn SmartPLS 4 này sẽ chỉ bạn cách trình bày kết quả một cách chuyên nghiệp trong chương 4 của luận văn.
Cách trình bày mẫu kết quả mô hình đo lường
Bạn nên tổng hợp các chỉ số vào một bảng duy nhất để người đọc dễ theo dõi. Dưới đây là một ví dụ.
Bảng 1: Kết quả đánh giá độ tin cậy và giá trị hội tụ của thang đo
| Nhân tố | Biến quan sát | Outer Loading | Cronbach’s Alpha | Composite Reliability (CR) | AVE |
| Sự hài lòng (SHL) | SHL1 | 0.852 | 0.887 | 0.921 | 0.745 |
| SHL2 | 0.889 | ||||
| SHL3 | 0.841 | ||||
| Chất lượng DV (CLDV) | CLDV1 | 0.811 | 0.850 | 0.899 | 0.690 |
| CLDV2 | 0.865 | ||||
| CLDV3 | 0.798 |
Nhận xét sau bảng: “Kết quả tại Bảng 1 cho thấy tất cả các thang đo đều đạt yêu cầu về độ tin cậy và giá trị. Cụ thể, các chỉ số Cronbach’s Alpha và Composite Reliability đều lớn hơn 0.7, các hệ số tải ngoài (Outer Loadings) đều cao hơn 0.7, và chỉ số AVE của các nhân tố đều vượt ngưỡng 0.5.”
Cách trình bày mẫu kết quả mô hình cấu trúc
Sau khi chứng minh mô hình đo lường đạt chuẩn, bạn trình bày bảng kiểm định giả thuyết từ kết quả Bootstrapping.
Bảng 2: Kết quả kiểm định các giả thuyết nghiên cứu
| Giả thuyết | Mối quan hệ | Hệ số tác động (β) | Giá trị T | P-Values | Kết luận |
| H1 | CLDV → SHL | 0.658 | 12.541 | 0.000 | Chấp nhận |
| H2 | SHL → LTT | 0.472 | 7.819 | 0.000 | Chấp nhận |
| H3 | CLDV → LTT | 0.105 | 1.623 | 0.105 | Bác bỏ |
Nhận xét sau bảng: “Kết quả kiểm định tại Bảng 2 cho thấy giả thuyết H1 và H2 được chấp nhận ở mức ý nghĩa 5% (p < 0.05). Cụ thể, Chất lượng dịch vụ có tác động dương đến Sự hài lòng (β = 0.658, p < 0.001). Ngược lại, giả thuyết H3 bị bác bỏ do không có ý nghĩa thống kê (p = 0.105 > 0.05).”
Việc nắm vững hướng dẫn SmartPLS 4 không chỉ giúp bạn thực hiện phân tích một cách chính xác mà còn nâng cao chất lượng và tính thuyết phục cho bài nghiên cứu của mình. Nếu bạn gặp khó khăn trong quá trình xử lý dữ liệu, chạy mô hình phức tạp hoặc diễn giải kết quả, đội ngũ chuyên gia của xulysolieu.info luôn sẵn sàng hỗ trợ. Chúng tôi cung cấp các dịch vụ tư vấn, xử lý số liệu chuyên sâu trên SPSS, AMOS, SmartPLS, STATA, giúp bạn gỡ rối dữ liệu xấu và hoàn thành luận văn một cách xuất sắc.
Thông Tin Liên Hệ
* Hotline/Zalo: 0878.968.468
* Email: cs@xulysolieu.info
* Website: xulysolieu.info
Fornell và Larcker: Đánh giá tính phân biệt trong SEM
Khi tiến hành phân tích mô hình cấu trúc tuyến tính SEM-PLS, việc đảm bảo các khái niệm nghiên cứu thực sự khác biệt nhau là một yêu cầu bắt buộc để mô hình có giá trị. Tiêu chuẩn Fornell và Larcker (1981) từ lâu đã trở thành công cụ nền tảng để đánh giá tính phân biệt (Discriminant Validity) của các biến tiềm ẩn. Phương pháp này giúp khẳng định rằng mỗi biến tiềm ẩn trong mô hình đo lường một khía cạnh riêng biệt, không bị chồng chéo hay nhầm lẫn với các biến khác. Mặc dù các phương pháp mới hơn đã ra đời, việc hiểu và áp dụng thành thạo tiêu chuẩn Fornell và Larcker vẫn là một kỹ năng cốt lõi đối với bất kỳ nhà nghiên cứu nào sử dụng SmartPLS 4.
Bài viết này sẽ cung cấp một hướng dẫn chi tiết, từ lý thuyết đến thực hành, về cách áp dụng tiêu chuẩn Fornell và Larcker để đánh giá và cải thiện tính phân biệt trong mô hình SEM. Chúng tôi sẽ đi sâu vào nguyên lý, quy trình thực hiện trên SmartPLS 4, cách diễn giải kết quả, và các giải pháp xử lý khi mô hình không đạt yêu cầu.
1. Mục Đích Của Phương Pháp Fornell và Larcker
Mục đích chính của phương pháp Fornell và Larcker là kiểm tra và xác nhận tính hợp lệ phân biệt (Discriminant Validity) giữa các biến tiềm ẩn (latent constructs) trong một mô hình đo lường. Tính hợp lệ phân biệt là một khía cạnh quan trọng của tính hợp lệ cấu trúc, đảm bảo rằng một biến tiềm ẩn thực sự khác biệt với các biến tiềm ẩn khác. Nếu không có tính phân biệt, các kết quả từ mô hình cấu trúc (kiểm định giả thuyết) có thể trở nên sai lệch và không đáng tin cậy, vì chúng ta không thể chắc chắn biến độc lập nào đang thực sự tác động đến biến phụ thuộc.
Nguyên lý cốt lõi của tiêu chuẩn Fornell và Larcker rất trực quan: một biến tiềm ẩn phải giải thích cho sự biến thiên của các biến quan sát (indicators) của chính nó nhiều hơn là sự biến thiên của các biến tiềm ẩn khác. Nói cách khác, mức độ liên kết nội tại của một khái niệm phải mạnh hơn mức độ liên kết của nó với các khái niệm khác. Để lượng hóa nguyên lý này, phương pháp so sánh căn bậc hai của Phương sai trích trung bình (AVE) của mỗi biến với hệ số tương quan giữa biến đó và tất cả các biến khác trong mô hình.
Tác động của việc này là rất lớn. Khi một mô hình đạt được tính phân biệt theo tiêu chuẩn Fornell và Larcker, nhà nghiên cứu có thể tự tin rằng các thang đo mình sử dụng đang đo lường đúng các khái niệm lý thuyết riêng biệt. Điều này tạo ra một nền tảng vững chắc để tiếp tục phân tích các mối quan hệ tác động trong mô hình cấu trúc, giúp tăng cường độ tin cậy và giá trị khoa học của toàn bộ nghiên cứu.
2. Định Nghĩa và Ý Nghĩa Của AVE
Phương sai trích trung bình, hay Average Variance Extracted (AVE), là một chỉ số quan trọng dùng để đánh giá tính hội tụ (Convergent Validity) của một biến tiềm ẩn. Về mặt khái niệm, AVE đo lường mức độ biến thiên trung bình của các biến quan sát thành phần được giải thích bởi biến tiềm ẩn. Một giá trị AVE cao cho thấy biến tiềm ẩn đó nắm bắt được phần lớn thông tin chung từ các biến quan sát của nó, chứng tỏ các biến quan sát này hội tụ tốt để đo lường cùng một khái niệm.
Công thức tính AVE cho một biến tiềm ẩn là trung bình cộng của bình phương các hệ số tải chuẩn hóa (standardized outer loadings) của các biến quan sát thuộc biến tiềm ẩn đó. Theo quy ước chung trong nghiên cứu, một biến tiềm ẩn được xem là đạt tính hội tụ khi có giá trị AVE lớn hơn hoặc bằng 0.50. Ngưỡng này có nghĩa là biến tiềm ẩn giải thích được ít nhất 50% phương sai của các biến quan sát cấu thành nó.
Trong khuôn khổ của tiêu chuẩn Fornell và Larcker, chỉ số AVE đóng vai trò trung tâm. Thay vì sử dụng trực tiếp AVE, phương pháp này sử dụng căn bậc hai của AVE (SQRT(AVE)). Giá trị SQRT(AVE) đại diện cho mức độ tương quan trung bình của biến tiềm ẩn với các chỉ báo của chính nó. Bằng cách so sánh giá trị này với các hệ số tương quan giữa các biến tiềm ẩn khác nhau, chúng ta có thể kiểm tra xem liệu một biến có “gần gũi” với chính nó hơn là với các biến khác hay không. Do đó, một AVE thấp không chỉ ảnh hưởng đến tính hội tụ mà còn trực tiếp làm suy yếu khả năng đạt được tính phân biệt theo tiêu chuẩn Fornell và Larcker.
3. Quy Trình Kiểm Tra Phân Biệt Bằng Bảng Fornell và Larcker
SmartPLS 4 cung cấp một giao diện trực quan và quy trình hợp lý để thực hiện kiểm định tính phân biệt. Để chạy và lấy kết quả bảng Fornell và Larcker, các nhà nghiên cứu cần thực hiện theo các bước cụ thể sau đây.
- Bước 1: Xây dựng mô hình SEM trong SmartPLS 4.
Đầu tiên, bạn cần đảm bảo mô hình đo lường và mô hình cấu trúc đã được vẽ chính xác trong giao diện đồ họa của SmartPLS. Các biến tiềm ẩn (hình tròn màu xanh) phải được liên kết đúng với các biến quan sát (hình chữ nhật màu vàng). Quan trọng nhất, bạn phải xác định đúng loại mô hình đo lường là dạng kết quả (Reflective), vì tiêu chuẩn Fornell và Larcker chỉ áp dụng cho loại mô hình này. - Bước 2: Tính toán các giá trị AVE và hệ số tương quan.
Từ cửa sổ mô hình, điều hướng đến thanh công cụ và chọn Calculate -> PLS-SEM Algorithm. Một hộp thoại cài đặt sẽ xuất hiện. Trong hầu hết các trường hợp, bạn có thể giữ nguyên các thiết lập mặc định (Path, 7, 300). Nhấp vào Start Calculation. Phần mềm sẽ tự động chạy thuật toán và tính toán tất cả các chỉ số cần thiết, bao gồm hệ số tải, AVE, độ tin cậy tổng hợp, và ma trận tương quan giữa các biến tiềm ẩn. - Bước 3: Phân tích và xử lý kết quả từ bảng Fornell và Larcker.
Sau khi thuật toán chạy xong, cửa sổ kết quả sẽ hiện ra. Ở khung điều hướng bên trái, tìm đến mục Quality Criteria và chọn Discriminant Validity. Trong cửa sổ chính, kết quả sẽ hiển thị nhiều tab khác nhau. Bạn hãy nhấp vào tab có tên Fornell-Larcker Criterion. Đây chính là bảng ma trận mà bạn cần để đánh giá. Bước tiếp theo là diễn giải bảng này một cách chính xác để đưa ra kết luận về tính phân biệt của mô hình.
4. Phân Tích Kết Quả Qua Bảng Fornell và Larcker
Việc đọc và hiểu đúng bảng kết quả Fornell và Larcker là kỹ năng then chốt để đưa ra kết luận chính xác. Bảng này có cấu trúc dạng ma trận vuông, với các biến tiềm ẩn được liệt kê trên cả hàng và cột.
Cấu trúc của bảng rất rõ ràng:
- Các giá trị trên đường chéo chính (in đậm): Đây chính là căn bậc hai của Phương sai trích trung bình (SQRT(AVE)) của từng biến tiềm ẩn tương ứng.
- Các giá trị nằm ngoài đường chéo chính: Đây là các hệ số tương quan (correlation coefficients) giữa các cặp biến tiềm ẩn.
Để phân tích, bạn thực hiện quy tắc so sánh đơn giản cho từng cột (hoặc hàng). Lấy giá trị SQRT(AVE) (số in đậm) ở đầu cột, sau đó so sánh nó với tất cả các hệ số tương quan bên dưới nó trong cùng một cột. Nếu giá trị SQRT(AVE) lớn hơn tất cả các hệ số tương quan đó, thì biến tiềm ẩn đó đạt được tính phân biệt. Lặp lại quy trình này cho tất cả các cột. Mô hình chỉ được coi là hoàn toàn đạt yêu cầu khi tất cả các biến tiềm ẩn đều thỏa mãn điều kiện này.
Ví dụ thực tế: Giả sử một mô hình có ba biến: Sự hài lòng (HL), Chất lượng dịch vụ (CLDV), và Lòng trung thành (LTT). Bảng kết quả Fornell và Larcker có thể trông như sau:
| CLDV | HL | LTT | |
|---|---|---|---|
| CLDV | 0.855 | ||
| HL | 0.650 | 0.821 | |
| LTT | 0.580 | 0.710 | 0.884 |
- Phân tích biến CLDV: SQRT(AVE) là 0.855. Giá trị này lớn hơn tương quan với HL (0.650) và LTT (0.580). Vậy CLDV đạt tính phân biệt.
- Phân tích biến HL: SQRT(AVE) là 0.821. Giá trị này lớn hơn tương quan với CLDV (0.650) và LTT (0.710). Vậy HL đạt tính phân biệt.
- Phân tích biến LTT: SQRT(AVE) là 0.884. Giá trị này lớn hơn tương quan với CLDV (0.580) và HL (0.710). Vậy LTT đạt tính phân biệt.
- Kết luận: Vì tất cả các biến đều thỏa mãn, mô hình nghiên cứu này đạt giá trị phân biệt theo tiêu chuẩn Fornell và Larcker.
5. Cải Thiện Kết Quả Nếu Không Đạt Yêu Cầu

Việc mô hình không vượt qua được kiểm định Fornell và Larcker là một vấn đề phổ biến, đặc biệt với các khái niệm nghiên cứu có sự tương đồng về mặt lý thuyết. Khi SQRT(AVE) của một biến A nhỏ hơn hệ số tương quan của nó với biến B, điều này cho thấy có sự chồng chéo nghiêm trọng. Dưới đây là các giải pháp thực tiễn để khắc phục.
- Giải pháp 1: Cải thiện chỉ số AVE:
Nguyên nhân gốc rễ thường đến từ giá trị AVE thấp. Để tăng AVE, bạn cần quay lại xem xét bảng hệ số tải ngoài (Outer Loadings). Các biến quan sát có hệ số tải thấp (ví dụ, dưới 0.7) đóng góp rất ít vào việc giải thích biến tiềm ẩn và làm giảm AVE. Hãy cân nhắc loại bỏ các biến quan sát có hệ số tải yếu nhất (đặc biệt là những biến dưới 0.4), sau đó chạy lại thuật toán PLS-SEM. Việc loại bỏ này sẽ giúp tăng AVE và do đó tăng SQRT(AVE), cải thiện cơ hội đạt chuẩn Fornell và Larcker. - Giải pháp 2: Khắc phục lỗi tải chéo (Cross-Loadings):
Một nguyên nhân khác là hiện tượng tải chéo, khi một biến quan sát của nhân tố này lại có hệ số tải cao trên một nhân tố khác. Để kiểm tra, hãy xem bảng Cross-Loadings. Nếu một chỉ báo của biến A lại có hệ số tải trên biến B cao hơn hoặc xấp xỉ hệ số tải trên chính biến A, thì chỉ báo đó đang gây nhiễu. Nó làm mờ ranh giới giữa hai khái niệm và làm tăng tương quan giữa chúng. Việc loại bỏ chỉ báo gây nhiễu này là một giải pháp hiệu quả để giảm tương quan và cải thiện tính phân biệt. - Ví dụ xử lý: Một nhà nghiên cứu đang đo lường “Động lực làm việc” (ĐL) và “Cam kết tổ chức” (CK). Kết quả cho thấy SQRT(AVE) của ĐL (0.78) nhỏ hơn tương quan giữa ĐL và CK (0.82), vi phạm tiêu chuẩn Fornell và Larcker. Kiểm tra bảng Cross-Loadings, họ phát hiện biến quan sát “Tôi sẵn sàng nỗ lực hơn vì tổ chức” (thuộc thang đo ĐL) có hệ số tải trên CK là 0.75, trong khi tải trên ĐL chỉ là 0.68. Biến quan sát này rõ ràng đang đo lường sự cam kết nhiều hơn là động lực. Sau khi loại bỏ biến quan sát này và chạy lại phân tích, tương quan giữa ĐL và CK giảm xuống 0.70 và mô hình đạt yêu cầu về tính phân biệt.
6. Đo Lường Đặc Điểm Khác Trong SEM

Mặc dù tiêu chuẩn Fornell và Larcker rất quan trọng, nó chỉ là một phần của quy trình đánh giá mô hình đo lường toàn diện. Nhà nghiên cứu cần xem xét nó cùng với các chỉ số chất lượng khác để có cái nhìn tổng thể.
Trước hết là các chỉ số về độ tin cậy. Composite Reliability rho_a và rho_c là gì? Cả hai chỉ số này đều dùng để đánh giá độ tin cậy nhất quán nội tại của thang đo, tương tự như Cronbach’s Alpha nhưng được cho là ước tính chính xác hơn trong môi trường PLS-SEM. Giá trị rho_a (còn gọi là độ tin cậy nhất quán) và rho_c (trước đây gọi là độ tin cậy tổng hợp – CR) nên lớn hơn 0.70 để đảm bảo thang đo là đáng tin cậy.
Quan trọng hơn, trong những năm gần đây, giới học thuật đã có sự chuyển dịch về tiêu chuẩn đánh giá tính phân biệt. Nghiên cứu của Henseler và cộng sự (2015) đã chỉ ra rằng tiêu chuẩn Fornell và Larcker đôi khi không đủ “nhạy” để phát hiện các vấn đề về tính phân biệt, đặc biệt khi các biến tiềm ẩn có độ tương quan cao. Họ đã đề xuất một chỉ số mới và chặt chẽ hơn: Heterotrait-Monotrait Ratio of Correlations (HTMT). Vậy chỉ số HTMT là gì? HTMT là tỷ lệ giữa tương quan trung bình của các chỉ báo giữa các biến tiềm ẩn khác nhau (heterotrait) và tương quan trung bình của các chỉ báo trong cùng một biến tiềm ẩn (monotrait). Để đạt tính phân biệt, giá trị HTMT cần nhỏ hơn 0.90, hoặc một ngưỡng nghiêm ngặt hơn là 0.85. Hiện nay, nhiều tạp chí khoa học uy tín yêu cầu báo cáo HTMT như một tiêu chuẩn chính thay thế hoặc bổ sung cho phương pháp Fornell và Larcker.
7. Phương Pháp Trình Bày Kết Quả Nghiên Cứu
Trình bày kết quả một cách chuyên nghiệp và rõ ràng là yếu tố quyết định để thuyết phục người đọc về chất lượng nghiên cứu của bạn. Dưới đây là mẫu trình bày bảng biểu và cách viết phân tích cho phần này trong luận văn.
- Mẫu bảng trình bày trong luận văn:
Bảng cần có tiêu đề rõ ràng, ghi chú giải thích các giá trị và trích dẫn nguồn (là kết quả phân tích của chính tác giả). Các giá trị SQRT(AVE) trên đường chéo nên được in đậm để dễ nhận biết.
Bảng 1: Kết quả kiểm định giá trị phân biệt theo tiêu chuẩn Fornell và Larcker
| Biến tiềm ẩn | 1. Đào tạo | 2. Động lực | 3. Hài lòng | 4. Hiệu quả |
|---|---|---|---|---|
| 1. Đào tạo | 0.785 | |||
| 2. Động lực | 0.412 | 0.812 | ||
| 3. Hài lòng | 0.531 | 0.380 | 0.798 | |
| 4. Hiệu quả | 0.245 | 0.612 | 0.490 | 0.834 |
*Ghi chú: Các giá trị in đậm trên đường chéo là căn bậc hai của AVE. Các giá trị khác là hệ số tương quan giữa các biến tiềm ẩn. Nguồn: Phân tích từ SmartPLS 4 của tác giả, 2023.
- Hướng dẫn viết đoạn phân tích kết quả theo tiêu chuẩn hàn lâm:
Sau khi trình bày bảng, bạn cần viết một đoạn văn diễn giải các kết quả đó một cách logic và thuyết phục, liên hệ trực tiếp đến lý thuyết.
“Để đánh giá giá trị phân biệt (Discriminant Validity) của các thang đo, nghiên cứu sử dụng tiêu chuẩn Fornell và Larcker (1981). Theo tiêu chuẩn này, giá trị phân biệt được đảm bảo khi căn bậc hai của phương sai trích trung bình (SQRT(AVE)) của một biến tiềm ẩn lớn hơn tất cả các hệ số tương quan giữa biến đó với các biến khác trong mô hình.
Kết quả từ Bảng 1 cho thấy, biến “Đào tạo” có SQRT(AVE) là 0.785, lớn hơn các hệ số tương quan với “Động lực” (0.412), “Hài lòng” (0.531) và “Hiệu quả” (0.245). Tương tự, các giá trị SQRT(AVE) trên đường chéo của các biến “Động lực” (0.812), “Hài lòng” (0.798) và “Hiệu quả” (0.834) đều cao hơn các hệ số tương quan tương ứng trong cùng cột và hàng.
Do đó, có thể kết luận rằng tất cả các biến tiềm ẩn trong mô hình nghiên cứu đều đạt được giá trị phân biệt theo tiêu chuẩn Fornell và Larcker. Điều này khẳng định rằng các thang đo đang đo lường các khái niệm riêng biệt, tạo tiền đề vững chắc cho việc phân tích mô hình cấu trúc ở bước tiếp theo.”
Việc nắm vững cách áp dụng, diễn giải và xử lý các vấn đề liên quan đến tiêu chuẩn Fornell và Larcker là một kỹ năng không thể thiếu. Nếu bạn gặp khó khăn trong quá trình phân tích dữ liệu, từ việc kiểm tra độ tin cậy thang đo, đánh giá tính hội tụ, tính phân biệt cho đến việc chạy và diễn giải mô hình SEM trên SmartPLS, AMOS, STATA, đội ngũ chuyên gia của chúng tôi luôn sẵn sàng hỗ trợ. Chúng tôi cung cấp dịch vụ xử lý số liệu, tư vấn và gỡ lỗi mô hình để đảm bảo nghiên cứu của bạn đạt chất lượng cao nhất
Cách Chạy PLS-SEM Hiệu Quả Trên SmartPLS 4
Việc nắm vững cách chạy PLS-SEM là một kỹ năng then chốt đối với các nhà nghiên cứu, học viên cao học và sinh viên khi thực hiện các mô hình phương trình cấu trúc trong luận văn. Phương pháp này đặc biệt mạnh mẽ khi xử lý các mô hình phức tạp, dữ liệu không tuân theo phân phối chuẩn hoặc kích thước mẫu nhỏ. Bài viết này, được biên soạn bởi các chuyên gia tại xulysolieu.info, sẽ cung cấp một hướng dẫn chi tiết, từ cơ bản đến nâng cao, về cách chạy PLS-SEM và Bootstrapping trên phần mềm SmartPLS 4, dựa trên các tiêu chuẩn học thuật cập nhật nhất từ Hair và cộng sự (2022, 2024).
Mục tiêu của bài viết là giúp bạn không chỉ thực hiện đúng các thao tác kỹ thuật mà còn hiểu sâu sắc ý nghĩa đằng sau mỗi chỉ số. Chúng tôi sẽ đi qua từng bước, từ chuẩn bị dữ liệu, vẽ mô hình, phân tích kết quả, xử lý các lỗi thường gặp và cuối cùng là cách trình bày chuyên nghiệp trong bài nghiên cứu của bạn. Dù bạn đang tìm hiểu PLS-SEM là gì hay cần một quy trình chuẩn để chạy phân tích, đây là cẩm nang toàn diện dành cho bạn.
1. Tổng quan về PLS-SEM và Bootstrapping trong SmartPLS 4
Trước khi đi vào các bước kỹ thuật, việc hiểu rõ bản chất của PLS-SEM và vai trò của Bootstrapping là vô cùng quan trọng. Đây là nền tảng lý thuyết giúp bạn diễn giải kết quả một cách chính xác và tự tin bảo vệ nghiên cứu của mình.
1.1 PLS-SEM là gì?
PLS-SEM (Partial Least Squares Structural Equation Modeling) là một phương pháp phân tích mô hình phương trình cấu trúc dựa trên phương sai (variance-based). Khác với CB-SEM (phân tích trên AMOS) vốn yêu cầu khắt khe về phân phối chuẩn của dữ liệu, PLS-SEM linh hoạt hơn và được xem là công cụ lý tưởng để kiểm định các lý thuyết phức tạp, đặc biệt trong các giai đoạn nghiên cứu khám phá. Nó hoạt động hiệu quả với cả kích thước mẫu nhỏ và các mô hình có nhiều biến tiềm ẩn và biến quan sát.
Bootstrapping là một kỹ thuật thống kê phi tham số, được sử dụng để ước tính độ chính xác của các tham số trong mô hình. Trong bối cảnh PLS-SEM, vì phương pháp này không đưa ra giả định về phân phối dữ liệu, Bootstrapping đóng vai trò thiết yếu để kiểm định ý nghĩa thống kê của các hệ số trong mô hình (ví dụ: hệ số đường dẫn, hệ số tải). Nó hoạt động bằng cách tạo ra một số lượng lớn các mẫu con (ví dụ: 5.000 hoặc 10.000 mẫu) từ dữ liệu gốc thông qua việc lấy mẫu lặp lại có thay thế, từ đó xây dựng các khoảng tin cậy và tính toán giá trị p-value cho các giả thuyết nghiên cứu.
2. Các bước thực hiện Cách chạy PLS-SEM hiệu quả trên SmartPLS 4
Quy trình chuẩn cho cách chạy PLS-SEM trên phần mềm SmartPLS 4 bao gồm ba bước chính, từ khâu chuẩn bị dữ liệu đến khi thực hiện thuật toán phân tích. Việc tuân thủ đúng trình tự sẽ đảm bảo kết quả chính xác và đáng tin cậy.
Bước 1: Chuẩn bị dữ liệu và nhập vào phần mềm
Chất lượng của dữ liệu đầu vào quyết định trực tiếp đến chất lượng của kết quả phân tích. Trước khi nhập dữ liệu vào SmartPLS 4, bạn cần thực hiện các bước làm sạch và định dạng cẩn thận. Dữ liệu cần được mã hóa dưới dạng số (ví dụ: thang đo Likert 1-5), xử lý các giá trị bị thiếu (missing values) và đảm bảo không có lỗi nhập liệu.
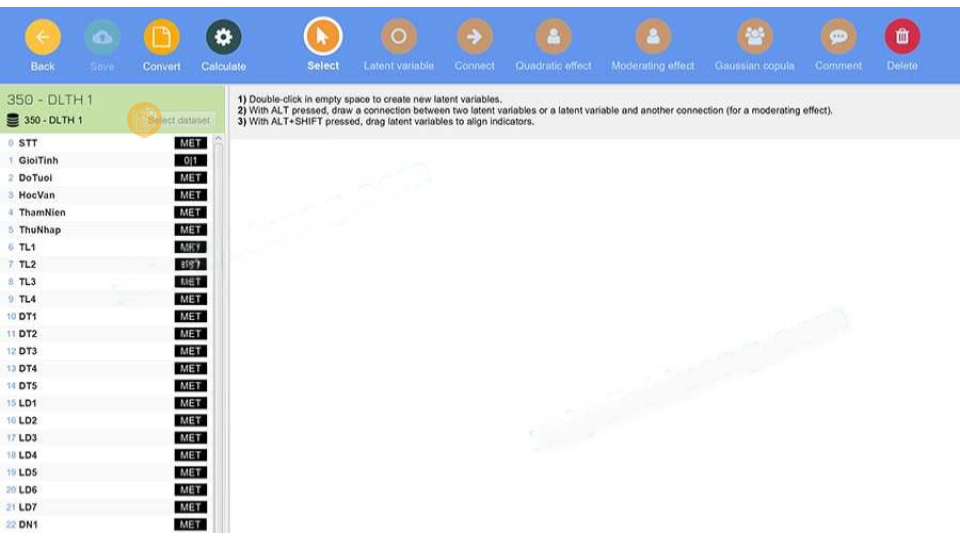
Sau khi làm sạch, hãy lưu tệp dữ liệu của bạn dưới định dạng được SmartPLS hỗ trợ như .csv (khuyến nghị) hoặc .xlsx. Tại giao diện chính của phần mềm, chọn “New Project” để tạo dự án mới, sau đó nhấp vào “Import Data File” để tải tệp dữ liệu của bạn lên. Phần mềm sẽ tự động đọc dữ liệu và hiển thị một bảng xem trước, nơi bạn có thể kiểm tra và điều chỉnh lại loại thang đo cho từng biến (ví dụ: Metric, Nominal).
Bước 2: Vẽ mô hình cấu trúc trong SmartPLS 4
Sau khi nhập dữ liệu thành công, bước tiếp theo là trực quan hóa mô hình nghiên cứu của bạn. Trong cửa sổ dự án, chọn “Create Model” và chọn loại mô hình là “PLS-SEM”. Giao diện vẽ mô hình sẽ xuất hiện, cho phép bạn kéo thả các biến quan sát từ danh sách bên trái vào vùng làm việc để tạo các biến tiềm ẩn (vòng tròn màu xanh).
Sử dụng công cụ “Connect” trên thanh công cụ để vẽ các mối quan hệ giả thuyết. Mũi tên sẽ đi từ biến độc lập đến biến phụ thuộc để thể hiện các tác động trực tiếp. Hãy đảm bảo rằng mỗi biến tiềm ẩn được đo lường bởi các biến quan sát tương ứng và các mối quan hệ cấu trúc được vẽ đúng theo khung lý thuyết bạn đã xây dựng. Đây là bước quan trọng để cụ thể hóa mô hình lý thuyết thành một sơ đồ có thể phân tích được.
Bước 3: Chạy thuật toán PLS-SEM
Bước này nhằm mục đích đánh giá mô hình đo lường, kiểm tra xem các thang đo có đạt độ tin cậy và giá trị cần thiết hay không. Đây là bước đầu tiên và cơ bản nhất trong quy trình thực hiện cách chạy PLS-SEM.
Tại giao diện sơ đồ mô hình, chọn menu “Calculate” và nhấp vào “PLS-SEM Algorithm”. Một cửa sổ cấu hình sẽ hiện ra. Đối với hầu hết các nghiên cứu, bạn có thể giữ nguyên các thiết lập mặc định:
- Weighting Scheme: Path
- Maximum Iterations: 300 (Số lần lặp tối đa để thuật toán hội tụ)
- Stop Criterion: 10-7 (Ngưỡng dừng khi sự thay đổi giữa các lần lặp là không đáng kể)
Nhấn “Start Calculation” để phần mềm bắt đầu chạy thuật toán. Kết quả thu được sẽ được sử dụng để đánh giá chất lượng của các thang đo trước khi tiến hành kiểm định giả thuyết.
3. Giao diện kết quả PLS-SEM Algorithm và các thông số chính
Sau khi chạy thuật toán PLS-SEM, SmartPLS 4 sẽ hiển thị một giao diện kết quả toàn diện. Hiểu rõ cách đọc và tùy chỉnh giao diện này sẽ giúp bạn khai thác tối đa thông tin phân tích.
3.1 Kết quả kiểm định thống kê

Báo cáo kết quả được trình bày một cách có hệ thống. Dưới đây là các chỉ số quan trọng nhất bạn cần quan tâm trong lần chạy đầu tiên này:
- Outer Loadings (Hệ số tải ngoài): Nằm trong mục “Quality Criteria”, chỉ số này cho biết mức độ liên kết giữa từng biến quan sát và biến tiềm ẩn mà nó đo lường. Đây là chỉ số đầu tiên cần xem xét để đánh giá độ tin cậy của từng chỉ báo.
- R2 (R-Square): Hệ số xác định, phản ánh mức độ phần trăm phương sai của một biến tiềm ẩn phụ thuộc được giải thích bởi các biến tiềm ẩn độc lập tác động lên nó.
- Path Coefficients (Hệ số đường dẫn): Thể hiện cường độ và chiều hướng của mối quan hệ trực tiếp giữa các biến tiềm ẩn trong mô hình. Tuy nhiên, ở bước này, chúng chưa được kiểm định ý nghĩa thống kê.
- Indirect Effects (Tác động gián tiếp): Thể hiện các tác động thông qua biến trung gian, rất quan trọng nếu mô hình của bạn có yếu tố trung gian.
3.2 Điều chỉnh hiển thị kết quả
SmartPLS 4 cung cấp khả năng tùy chỉnh hiển thị kết quả trực tiếp trên sơ đồ mô hình, giúp việc phân tích trở nên trực quan hơn. Ở khu vực điều chỉnh bên dưới danh sách kết quả, bạn có thể:
- Inner Model: Chọn hiển thị “Path Coefficients” hoặc các giá trị khác trên các mũi tên nối giữa các biến tiềm ẩn.
- Outer Model: Chọn hiển thị “Outer Loadings” trên các mũi tên nối từ biến tiềm ẩn đến biến quan sát.
- Constructs: Chọn hiển thị giá trị R2 bên trong các vòng tròn của biến phụ thuộc.
Sử dụng các tùy chọn này giúp bạn nhanh chóng có cái nhìn tổng quan về các hệ số quan trọng ngay trên sơ đồ mà không cần phải liên tục chuyển qua lại giữa các bảng báo cáo. Bạn cũng có thể sử dụng chức năng “Export to Excel” để xuất tất cả các bảng kết quả ra file Excel để lưu trữ và trình bày.
4. Thực hiện Bootstrapping để kiểm định ý nghĩa mô hình cấu trúc
Sau khi mô hình đo lường đã được xác nhận là đáng tin cậy, bước tiếp theo trong cách chạy PLS-SEM là thực hiện Bootstrapping để kiểm định các giả thuyết của mô hình cấu trúc.
Bước 1: Thiết lập Bootstrapping trong SmartPLS 4

Quay trở lại giao diện sơ đồ mô hình ban đầu. Chọn menu “Calculate” và lần này nhấp vào “Bootstrapping”. Một cửa sổ cấu hình sẽ xuất hiện, yêu cầu bạn thiết lập các thông số quan trọng cho quá trình tái lấy mẫu. Để đảm bảo kết quả có giá trị học thuật, hãy tuân thủ các thiết lập chuẩn sau:
- Subsamples: Đặt số lượng mẫu con tối thiểu là 5,000. Đối với các nghiên cứu yêu cầu độ tin cậy cao hoặc để công bố quốc tế, con số 10,000 được khuyến nghị.
- Confidence interval method: Chọn Percentile Bootstrap, phương pháp phổ biến và được chấp nhận rộng rãi.
- Test Type: Chọn Two-tailed (Kiểm định hai phía), vì hầu hết các giả thuyết nghiên cứu kinh tế – xã hội đều không xác định trước chiều hướng tác động.
- Significance level: Giữ nguyên ở mức 0.05 (tương ứng với độ tin cậy 95%).
Sau khi thiết lập, nhấn “Start Calculation”. Quá trình này có thể mất nhiều thời gian hơn so với PLS-SEM Algorithm vì máy tính phải thực hiện hàng nghìn lần lặp.
Bước 2: Kết quả và cách giải thích dữ liệu Bootstrapping

Kết quả từ Bootstrapping cung cấp các thông số cần thiết để kết luận về giả thuyết nghiên cứu. Ba chỉ số quan trọng nhất cần xem xét là:
- P-Value (Giá trị p): Đây là chỉ số phổ biến nhất. Một giả thuyết được chấp nhận về mặt thống kê nếu p-value < 0.05.
- T-Statistics (Trị số t): Đo lường mức độ ý nghĩa của hệ số. Với kiểm định hai phía và mức ý nghĩa 5%, một mối quan hệ có ý nghĩa thống kê khi giá trị tuyệt đối của T-Statistics > 1.96.
- Confidence Intervals (Khoảng tin cậy): Cung cấp một khoảng giá trị ướcestimating cho hệ số. Nếu khoảng tin cậy (ví dụ: 95%) không chứa số 0, mối quan hệ đó có ý nghĩa thống kê.
Giao diện kết quả Bootstrapping tương tự như PLS-SEM, bạn có thể tùy chỉnh hiển thị giá trị p-value hoặc t-value trực tiếp trên sơ đồ mô hình để dễ dàng kết luận giả thuyết.
5. Cách phân tích và giải thích kết quả đầu ra từ PLS-SEM và Bootstrapping

Một quy trình phân tích và báo cáo kết quả PLS-SEM chuẩn luôn tuân theo trình tự: đánh giá mô hình đo lường trước, sau đó mới đến đánh giá mô hình cấu trúc.
5.1 Đánh giá mô hình đo lường
Sử dụng kết quả từ PLS-SEM Algorithm, bạn cần đánh giá các tiêu chí sau cho các thang đo phản ánh (reflective):
- Độ tin cậy chỉ báo (Indicator Reliability): Kiểm tra bảng Outer Loadings. Các hệ số tải phải lớn hơn hoặc bằng 0.708. Trong nghiên cứu khám phá, giá trị từ 0.40 đến 0.70 có thể được chấp nhận tạm thời nếu việc giữ lại chúng giúp cải thiện các chỉ số khác.
- Độ tin cậy nhất quán nội tại (Internal Consistency Reliability): Cronbach’s Alpha và Composite Reliability (CR) đều phải lớn hơn hoặc bằng 0.70. CR thường được ưu tiên hơn trong PLS-SEM.
- Giá trị hội tụ (Convergent Validity): Phương sai trích trung bình (Average Variance Extracted – AVE) phải lớn hơn hoặc bằng 0.50. Điều này có nghĩa là biến tiềm ẩn giải thích được ít nhất 50% phương sai của các biến quan sát cấu thành nó.
- Giá trị phân biệt (Discriminant Validity): Tiêu chuẩn hiện đại nhất là tỷ số HTMT (Heterotrait-Monotrait Ratio). Giá trị HTMT giữa hai biến tiềm ẩn bất kỳ phải nhỏ hơn 0.85 (tiêu chuẩn khắt khe) hoặc 0.90 (tiêu chuẩn nới lỏng).
5.2 Đánh giá mô hình cấu trúc
Sau khi mô hình đo lường đạt yêu cầu, bạn sử dụng kết quả từ Bootstrapping để đánh giá mô hình cấu trúc:
- Kiểm định giả thuyết: Dựa vào p-value (< 0.05) hoặc t-value (> 1.96) để kết luận chấp nhận hay bác bỏ các giả thuyết về tác động trực tiếp.
- Đánh giá mức độ giải thích (R2): Hệ số R2 của các biến phụ thuộc được đánh giá theo các ngưỡng tham khảo của Hair và cộng sự: 0.25 (yếu), 0.50 (trung bình), và 0.75 (mạnh).
- Kiểm tra đa cộng tuyến: Kiểm tra chỉ số VIF (Variance Inflation Factor) trong mục “Collinearity Statistics”. Tất cả các giá trị VIF nên nhỏ hơn 3.0 để đảm bảo không có vấn đề đa cộng tuyến nghiêm trọng giữa các biến độc lập.
- Kích thước tác động (f2): Chỉ số này đánh giá mức độ ảnh hưởng của một biến độc lập cụ thể lên biến phụ thuộc. Các ngưỡng tham khảo là: 0.02 (nhỏ), 0.15 (trung bình), và 0.35 (lớn).
6. Những vấn đề thường gặp và cách xử lý khi kết quả không như mong đợi

Trong thực tế, không phải lúc nào kết quả phân tích cũng hoàn hảo. Việc biết cách xử lý các lỗi phổ biến là một phần quan trọng của cách chạy PLS-SEM hiệu quả.
6.1 Các lỗi phổ biến trong phân tích PLS-SEM
Ví dụ thực tế 1: Xử lý khi AVE < 0.50 (Không đạt giá trị hội tụ)
Giả sử biến “Chất lượng dịch vụ” (CLDV) có chỉ số AVE là 0.45, không đạt ngưỡng 0.50.
- Bước 1: Mở bảng kết quả “Outer Loadings”. Bạn thấy biến quan sát CLDV4 có hệ số tải thấp nhất, chỉ 0.55, trong khi các biến khác đều trên 0.70.
- Bước 2: Quay lại mô hình, xóa biến quan sát CLDV4 ra khỏi biến tiềm ẩn “Chất lượng dịch vụ”.
- Bước 3: Chạy lại “PLS-SEM Algorithm”. Kết quả mới cho thấy AVE của CLDV đã tăng lên 0.58 và CR cũng được cải thiện. Việc loại bỏ chỉ báo yếu đã giúp thang đo hội tụ tốt hơn.
Ví dụ thực tế 2: Xử lý khi HTMT > 0.90 (Vi phạm giá trị phân biệt)
Giả sử tỷ số HTMT giữa hai biến “Sự hài lòng” và “Lòng trung thành” là 0.92, cho thấy người trả lời không phân biệt rõ hai khái niệm này.
- Bước 1: Kiểm tra bảng “Cross-Loadings”. Bạn phát hiện một câu hỏi của “Sự hài lòng” lại có hệ số tải cao gần bằng với biến “Lòng trung thành”. Đây là chỉ báo bị tải chéo.
- Bước 2: Loại bỏ chỉ báo gây nhiễu này và chạy lại phân tích.
- Bước 3: Nếu HTMT vẫn cao, hãy xem xét lại cơ sở lý thuyết. Có thể hai khái niệm này thực sự là một phần của một cấu trúc bậc cao hơn. Trong trường hợp đó, bạn có thể cân nhắc gộp chúng lại thành một biến duy nhất nếu lý thuyết cho phép.
6.2 Các chiến lược tối ưu hóa mô hình
Khi một giả thuyết bị bác bỏ (p > 0.05), đừng vội vàng thay đổi dữ liệu. Đây là một kết quả nghiên cứu và cần được biện giải một cách khoa học.
- Kiểm tra đa cộng tuyến (VIF): Một VIF cao (> 3 hoặc > 5) giữa các biến độc lập có thể làm triệt tiêu ý nghĩa thống kê của nhau. Hãy xem xét loại bỏ hoặc kết hợp các biến có VIF cao.
- Tìm kiếm biến điều tiết/trung gian: Có thể mối quan hệ giữa A và B không phải là tác động trực tiếp mà bị ảnh hưởng bởi một yếu tố thứ ba. Việc thêm biến điều tiết hoặc trung gian có thể làm rõ hơn mô hình.
- Biện luận dựa trên bối cảnh: Nếu không có vấn đề kỹ thuật nào, hãy giải thích kết quả dựa trên đặc thù của mẫu nghiên cứu, bối cảnh thị trường hoặc so sánh với các nghiên cứu trước đây. Một giả thuyết bị bác bỏ cũng là một phát hiện có giá trị.
7. Hướng dẫn trình bày kết quả phân tích trong luận văn
Trình bày kết quả một cách rõ ràng, chuyên nghiệp là bước cuối cùng và quan trọng nhất trong cách chạy PLS-SEM. Cấu trúc trình bày nên tuân theo logic phân tích.
7.1 Cách trình bày các chỉ số mô hình đo lường
Bạn nên lập hai bảng chính: một bảng cho độ tin cậy và giá trị hội tụ, một bảng cho giá trị phân biệt.
Bảng 1: Kết quả đánh giá độ tin cậy và giá trị hội tụ
| Biến tiềm ẩn | Biến quan sát | Outer Loading | Cronbach’s Alpha | Composite Reliability (CR) | AVE |
|---|---|---|---|---|---|
| Thương hiệu (TH) | TH1 TH2 TH3 |
0.812 0.795 0.840 |
0.785 | 0.861 | 0.672 |
| Giá cả (GC) | GC1 GC2 GC3 |
0.754 0.811 0.780 |
0.710 | 0.825 | 0.611 |
Bảng 2: Kết quả kiểm định giá trị phân biệt (Tỷ số HTMT)
| Khái niệm | 1. Thương hiệu | 2. Giá cả | 3. Quyết định mua |
|---|---|---|---|
| 1. Thương hiệu | |||
| 2. Giá cả | 0.642 | ||
| 3. Quyết định mua | 0.712 | 0.589 |
7.2 Phân tích kết quả mô hình cấu trúc trong báo cáo
Sử dụng bảng để tóm tắt kết quả kiểm định giả thuyết từ Bootstrapping. Đồng thời, vẽ lại sơ đồ kết quả từ SmartPLS vào báo cáo của bạn.
Bảng 3: Kết quả kiểm định các giả thuyết nghiên cứu
| Giả thuyết | Mối quan hệ | Hệ số (β) | t-value | p-value | Kết luận |
|---|---|---|---|---|---|
| H1 | Thương hiệu → Quyết định mua | 0.425 | 8.173 | 0.000 | Chấp nhận |
| H2 | Giá cả → Quyết định mua | 0.210 | 3.442 | 0.001 | Chấp nhận |
Bên cạnh các bảng, hãy trình bày sơ đồ mô hình cuối cùng với các thông số quan trọng (hệ số đường dẫn, p-value, R2) được hiển thị rõ ràng. Điều này giúp người đọc có cái nhìn trực quan và tổng thể về các kết quả chính của nghiên cứu.
Việc nắm vững cách chạy PLS-SEM và Bootstrapping trên Smart PLS 4 đòi hỏi sự kết hợp giữa kỹ năng thao tác phần mềm và kiến thức thống kê vững chắc. Nếu bạn gặp khó khăn trong quá trình xử lý dữ liệu, phân tích mô hình hoặc biện luận kết quả, đội ngũ chuyên gia của xulysolieu.info luôn sẵn sàng hỗ trợ. Chúng tôi cung cấp các dịch vụ tư vấn, xử lý dữ liệu, chạy mô hình (SPSS, AMOS, SmartPLS) và hỗ trợ hoàn thiện luận văn, đảm bảo nghiên cứu của bạn đạt chất lượng cao nhất.
Hướng dẫn phân tích biến trung gian bằng SPSS
Thực hiện phân tích biến trung gian là một kỹ năng cốt lõi trong nghiên cứu định lượng, giúp giải mã cơ chế “tại sao” một biến độc lập lại tác động lên biến phụ thuộc. Thay vì chỉ xác định mối quan hệ trực tiếp, kỹ thuật này cho phép nhà nghiên cứu khám phá con đường gián tiếp mà tác động được truyền dẫn. Việc nắm vững các phương pháp từ cổ điển như Sobel Test đến hiện đại như Bootstrapping với PROCESS Macro trong SPSS không chỉ nâng cao giá trị học thuật của một bài nghiên cứu có biến trung gian mà còn là yêu cầu bắt buộc của nhiều tạp chí khoa học uy tín.
Bài viết này là một hướng dẫn toàn diện, từ lý thuyết cơ bản, các bước chuẩn bị dữ liệu, đến thao tác chi tiết và cách diễn giải kết quả khi thực hiện phân tích biến trung gian.
Khái Niệm và Vai Trò của Biến Trung Gian trong Phân Tích Thống Kê
Định Nghĩa Biến Trung Gian
Biến trung gian (Mediator Variable), ký hiệu là M, là một biến số giải thích cho cơ chế hoặc quá trình mà một biến độc lập (X) ảnh hưởng đến một biến phụ thuộc (Y). Theo định nghĩa kinh điển của Baron & Kenny (1986), một biến được xem là trung gian khi nó nằm giữa trong chuỗi quan hệ nhân quả: X tác động đến M, và sau đó M tác động đến Y. Nói cách khác, biến trung gian trả lời câu hỏi “bằng cách nào” (how) hoặc “thông qua cơ chế gì” mà X gây ra sự thay đổi ở Y.
Để hiểu rõ hơn, cần phân biệt biến trung gian với các loại biến khác trong mô hình:
- Biến trung gian (Mediator): Giải thích mối quan hệ. Ví dụ: Sự hài lòng trong công việc (X) làm tăng cam kết tổ chức (M), từ đó làm giảm ý định nghỉ việc (Y). Ở đây, Cam kết tổ chức là biến trung gian.
- Biến điều tiết (Moderator): Thay đổi cường độ hoặc chiều hướng của mối quan hệ X-Y. Nó trả lời câu hỏi “khi nào” hoặc “với ai”. Ví dụ: Hỗ trợ từ cấp trên (Z) có thể làm mạnh thêm mối quan hệ giữa sự hài lòng (X) và hiệu suất công việc (Y).
- Biến kiểm soát (Control Variable): Là các yếu tố có thể ảnh hưởng đến Y nhưng không phải là trọng tâm của nghiên cứu. Chúng được đưa vào mô hình để loại bỏ các ảnh hưởng nhiễu, giúp đánh giá chính xác hơn tác động của X.
Các Thành Phần Cơ Bản trong Mô Hình Trung Gian
Một mô hình trung gian đơn giản bao gồm các thành phần cốt lõi sau:
- Biến độc lập (X): Nguyên nhân ban đầu, là biến tác động.
- Biến trung gian (M): Yếu tố truyền dẫn tác động từ X đến Y.
- Biến phụ thuộc (Y): Kết quả cuối cùng bị ảnh hưởng.
- Tác động trực tiếp (Direct Effect – c’): Là phần ảnh hưởng của X lên Y ngay cả khi đã kiểm soát sự hiện diện của biến trung gian M. Đây là con đường
X → Y. - Tác động gián tiếp (Indirect Effect – a*b): Là ảnh hưởng của X lên Y thông qua M. Tác động này là tích của hai con đường: tác động của X lên M (hệ số
a) và tác động của M lên Y (hệ sốb). Con đường này làX → M → Y. Tác động tổng (Total Effect – c) là tổng của tác động trực tiếp và gián tiếp:c = c' + a*b.
Các Bước Chuẩn Bị Trước Khi Thực Hiện Phân Tích Biến Trung Gian

Trước khi đi vào phân tích biến trung gian SPSS, việc đảm bảo chất lượng của dữ liệu và các biến số là bước bắt buộc. Bỏ qua giai đoạn này có thể dẫn đến kết quả sai lệch và không đáng tin cậy.
Kiểm Tra Chất Lượng Dữ Liệu
Để các biến đo lường (thường là các nhân tố tạo từ nhiều biến quan sát) đủ điều kiện đưa vào phân tích, chúng cần vượt qua hai kiểm định quan trọng:
- Đánh giá độ tin cậy của thang đo với Cronbach’s Alpha: Chỉ số này đo lường sự nhất quán nội tại của các mục hỏi trong cùng một thang đo. Một thang đo được xem là đáng tin cậy khi hệ số Cronbach’s Alpha lớn hơn 0.7 (Nunnally, 1978), hoặc có thể chấp nhận ở mức trên 0.6 đối với các nghiên cứu mới. Nếu Alpha thấp, nhà nghiên cứu cần xem xét loại bỏ các biến quan sát có hệ số tương quan biến-tổng (Corrected Item-Total Correlation) thấp để cải thiện độ tin cậy.
- Thực hiện phân tích nhân tố (EFA/CFA): Phân tích nhân tố khám phá (EFA) hoặc khẳng định (CFA) giúp xác định giá trị hội tụ và giá trị phân biệt. Giá trị hội tụ đảm bảo các biến quan sát đo lường đúng một khái niệm duy nhất. Giá trị phân biệt đảm bảo các khái niệm nghiên cứu (X, M, Y) là tách biệt và không bị chồng chéo. Nếu các biến của X và M cùng tải lên một nhân tố duy nhất trong EFA, có thể hai khái niệm này quá giống nhau, gây ra hiện tượng đa cộng tuyến và làm cho việc phân tích biến trung gian trở nên vô nghĩa.
Tính Toán Điểm Trung Bình
Sau khi các thang đo đã được xác nhận về độ tin cậy và giá trị, bước tiếp theo là tính toán giá trị đại diện cho mỗi nhân tố. Trong SPSS, kỹ thuật phổ biến nhất là tính điểm trung bình của tất cả các biến quan sát thuộc về một nhân tố.
Ví dụ, nếu biến độc lập “Chất lượng dịch vụ” (X) được đo bằng 5 câu hỏi (CLDV1 đến CLDV5), bạn sẽ vào menu Transform > Compute Variable. Trong hộp thoại, đặt tên cho biến mới (ví dụ: X_TB) và nhập công thức MEAN(CLDV1, CLDV2, CLDV3, CLDV4, CLDV5). Lặp lại quy trình này cho biến trung gian M và biến phụ thuộc Y. Các biến trung bình này (X_TB, M_TB, Y_TB) sẽ được sử dụng trực tiếp trong PROCESS Macro.
Quy Trình Thực Hiện Kiểm Định Sobel trong SPSS
Kiểm định Sobel là phương pháp truyền thống dựa trên cách tiếp cận của Baron & Kenny để xác định ý nghĩa thống kê của tác động gián tiếp. Mặc dù hiện nay ít được ưa chuộng hơn Bootstrapping, việc hiểu rõ quy trình này vẫn cung cấp một nền tảng lý thuyết vững chắc.
Triển Khai Mô Hình Baron & Kenny
Theo Baron & Kenny (1986), để kết luận có vai trò trung gian, cần thực hiện một chuỗi ba phân tích hồi quy và thỏa mãn các điều kiện sau:
- Bước 1 (Hồi quy X → Y): Biến độc lập X phải có tác động đáng kể lên biến phụ thuộc Y khi chưa có M (hệ số
ccó ý nghĩa thống kê). - Bước 2 (Hồi quy X → M): Biến độc lập X phải có tác động đáng kể lên biến trung gian M (hệ số
acó ý nghĩa thống kê). - Bước 3 (Hồi quy X, M → Y): Biến trung gian M phải có tác động đáng kể lên biến phụ thuộc Y khi đã kiểm soát X (hệ số
bcó ý nghĩa thống kê). Đồng thời, tác động của X lên Y (hệ sốc') phải giảm đi so với tác động ban đầu (c). Nếuc'không còn ý nghĩa thống kê, đó là trung gian hoàn toàn. Nếuc'vẫn có ý nghĩa nhưng nhỏ hơnc, đó là trung gian một phần.
Thực Hành Kiểm Định Sobel
Sau khi chạy ba mô hình hồi quy trên và có được các hệ số cần thiết, bạn cần sử dụng một công cụ tính toán trực tuyến để thực hiện kiểm định Sobel, vì SPSS không có chức năng này tích hợp sẵn.
- Từ kết quả hồi quy Bước 2 (
X → M), lấy hệ số chưa chuẩn hóa của X (giá trịa) và sai số chuẩn của nó (sa). - Từ kết quả hồi quy Bước 3 (
X, M → Y), lấy hệ số chưa chuẩn hóa của M (giá trịb) và sai số chuẩn của nó (sb). - Truy cập một trang web tính Sobel Test online (ví dụ: của Daniel Soper hoặc Quantpsy).
- Nhập 4 giá trị
a,sa,b,sbvào các ô tương ứng và nhấn tính toán.
Kết quả sẽ trả về một giá trị Z-score và p-value. Nếu p-value < 0.05, ta kết luận rằng tác động gián tiếp có ý nghĩa thống kê, và vai trò trung gian của M được xác nhận. Hạn chế lớn của Sobel Test là nó yêu cầu phân phối của tích a*b phải tuân theo quy luật phân phối chuẩn, điều này hiếm khi xảy ra trong thực tế, đặc biệt với cỡ mẫu nhỏ.
Phương Pháp Bootstrapping với PROCESS Macro
Bootstrapping là kỹ thuật hiện đại và mạnh mẽ, được khuyến nghị hàng đầu cho phân tích biến trung gian. Nó khắc phục được những nhược điểm cố hữu của Sobel Test.
Những Ưu Điểm Khi Sử Dụng Bootstrapping
Bootstrapping được xem là tiêu chuẩn vàng trong phân tích biến trung gian hiện đại vì những lý do sau:
- Không yêu cầu phân phối chuẩn: Kỹ thuật này không giả định về hình dạng phân phối của tác động gián tiếp. Thay vào đó, nó xây dựng một phân phối thực nghiệm từ chính dữ liệu mẫu.
- Độ chính xác cao với mẫu nhỏ: Bootstrapping cho kết quả đáng tin cậy ngay cả khi kích thước mẫu không lớn, một điểm yếu chí mạng của Sobel Test.
- Độ nhạy cao hơn: Phương pháp này có năng lực thống kê (statistical power) cao hơn, giúp phát hiện các tác động gián tiếp có thực mà Sobel Test có thể bỏ lỡ.
Quy trình Bootstrapping hoạt động bằng cách rút mẫu lặp lại có hoàn lại từ bộ dữ liệu gốc (thường là 5.000 hoặc 10.000 lần) để tạo ra hàng nghìn bộ dữ liệu mới. Với mỗi bộ dữ liệu, nó tính toán tác động gián tiếp a*b. Cuối cùng, nó xây dựng một khoảng tin cậy 95% (95% Confidence Interval – CI) cho tác động gián tiếp này. Nếu khoảng tin cậy không chứa số 0, tác động gián tiếp được coi là có ý nghĩa thống kê.
Cài Đặt và Chạy PROCESS Macro trong SPSS
PROCESS Macro là một add-on miễn phí cho SPSS do Andrew F. Hayes phát triển, giúp việc thực hiện Bootstrapping trở nên vô cùng đơn giản.
- Tải xuống: Truy cập trang web chính thức processmacro.org và tải file cài đặt tương ứng với phiên bản SPSS của bạn.
- Cài đặt: Mở SPSS, vào menu
Extensions > Install Local Extension Bundle(phiên bản mới) hoặcUtilities > Custom Dialogs > Install Custom Dialog(phiên bản cũ). Chọn file.spdđã tải về và cài đặt. Sau khi thành công, một mục mớiPROCESS vX.X by Andrew F. Hayessẽ xuất hiện trong menuAnalyze > Regression. - Thực hiện phân tích:
- Vào
Analyze > Regression > PROCESS. - Đưa biến phụ thuộc vào ô
Y variable. - Đưa biến độc lập vào ô
X variable. - Đưa biến trung gian vào ô
Mediator(s). - Tại ô
Model number, chọn4(đây là mô hình trung gian đơn giản). - Trong
Options, bạn có thể yêu cầu hiển thị thêm các hiệu ứng và biểu đồ. - Đảm bảo số lượng mẫu Bootstrap (
Number of bootstrap samples) được đặt ở mức 5000 hoặc cao hơn. - Nhấn
OKđể chạy phân tích.
- Vào
Cách Đọc và Giải Thích Kết Quả Phân Tích
Kết quả từ PROCESS Macro rất chi tiết. Bạn cần tập trung vào các phần chính để đưa ra kết luận cho giả thuyết nghiên cứu.
Phần Kết Quả của Mô Hình Biến Trung Gian
Kết quả output sẽ được chia thành nhiều phần, tương ứng với các phương trình hồi quy.
- Model for M (Outcome variable: M): Bảng này cho thấy kết quả của đường truyền
a(X → M). Hãy kiểm tra hệ số của X và giá trịp(Sig.). Nếup < 0.05, tác động từ X đến M có ý nghĩa. - Model for Y (Outcome variable: Y): Bảng này báo cáo kết quả của các đường truyền
b(M → Y) vàc'(X → Y). Tương tự, kiểm tra giá trịpcủa hệ số M và X để xác định ý nghĩa thống kê của chúng. - Total, Direct, and Indirect Effects of X on Y: Đây là phần quan trọng nhất. Nó tóm tắt tất cả các tác động.
Hướng Dẫn Trình Bày Kết Quả Bootstrapping về Tác động Gián Tiếp
Trong bảng kết quả tác động gián tiếp, hãy tìm đến dòng Indirect Effect(s) of X on Y. Bạn cần chú ý đến 3 cột: Effect (giá trị tác động gián tiếp a*b), BootLLCI (giới hạn dưới của khoảng tin cậy) và BootULCI (giới hạn trên của khoảng tin cậy).
Quy tắc vàng: Nếu khoảng tin cậy 95% từ BootLLCI đến BootULCI không chứa số 0, ta kết luận tác động gián tiếp có ý nghĩa thống kê.
- Ví dụ có ý nghĩa: Khoảng tin cậy là
[0.0890, 0.1980]. Vì cả hai giá trị đều dương và không chứa số 0, tác động gián tiếp là có ý nghĩa. - Ví dụ không có ý nghĩa: Khoảng tin cậy là
[-0.0720, 0.1250]. Vì khoảng này đi từ âm sang dương (chứa số 0), tác động gián tiếp không có ý nghĩa thống kê.
Những Thách Thức Phổ Biến và Giải Pháp Trong Phân Tích Biến Trung Gian

Không phải lúc nào việc phân tích biến trung gian cũng cho ra kết quả đẹp như mong đợi. Việc nhận diện và khắc phục các vấn đề phổ biến là kỹ năng quan trọng của một nhà nghiên cứu.
Các Lỗi Thường Gặp Khi Kiểm Định Tác Động Gián Tiếp
Vấn đề phổ biến nhất là khoảng tin cậy Bootstrapping của tác động gián tiếp chứa số 0, dẫn đến việc bác bỏ giả thuyết trung gian. Nguyên nhân có thể đến từ:
- Lý thuyết yếu: Mô hình
X → M → Ykhông có cơ sở lý thuyết vững chắc, dẫn đến mối liên hệ thực tế không tồn tại. - Cỡ mẫu nhỏ: Mặc dù Bootstrapping mạnh mẽ, một cỡ mẫu quá nhỏ (<100) vẫn có thể không đủ năng lực thống kê để phát hiện các tác động yếu.
- Một trong hai đường truyền
ahoặcbkhông có ý nghĩa: Nếu X không tác động lên M, hoặc M không tác động lên Y, thì tác động gián tiếp (a*b) sẽ tiến về 0 và không có ý nghĩa.
Cách khắc phục lỗi đa cộng tuyến và điểm ngoại lai trong dữ liệu
- Đa cộng tuyến (Multicollinearity): Xảy ra khi biến độc lập X và biến trung gian M quá tương quan với nhau (ví dụ: r > 0.8), khiến cho các ước lượng hệ số hồi quy trở nên không ổn định. Bạn có thể chẩn đoán bằng cách kiểm tra hệ số VIF (Variance Inflation Factor) trong hồi quy tuyến tính. Nếu VIF > 5, đó là dấu hiệu đáng lo ngại. Giải pháp là xem xét lại lý thuyết, có thể X và M đang đo lường cùng một khái niệm. Việc thực hiện EFA/CFA kỹ lưỡng ở bước chuẩn bị giúp ngăn chặn vấn đề này.
- Điểm ngoại lai (Outliers): Một vài quan sát dị biệt có thể làm sai lệch nghiêm trọng kết quả hồi quy. Hãy sử dụng biểu đồ Boxplot hoặc khoảng cách Cook’s (Cook’s Distance) để xác định và xem xét loại bỏ các điểm ngoại lai trước khi thực hiện phân tích biến trung gian.
Các Nguồn Tài Nguyên Hữu Ích và Kết Luận Nhanh
Để thực hiện thành công một bài nghiên cứu có biến trung gian, việc tham khảo thêm các tài liệu chuyên sâu và hiểu rõ ý nghĩa của phân tích là rất cần thiết.
Tài Liệu Tham Khảo và Hướng Dẫn Tiếp Theo
- Phần mềm và Hướng dẫn:
- Tải PROCESS Macro: https://www.processmacro.org/download.html
- Sách của tác giả: Andrew F. Hayes (2018), Introduction to Mediation, Moderation, and Conditional Process Analysis. Đây là cuốn sách gối đầu giường cho bất kỳ ai muốn làm chủ kỹ thuật này.
- Các phương pháp khác: Bên cạnh phân tích biến trung gian SPSS, các phần mềm như AMOS và SmartPLS cũng cung cấp các công cụ mạnh mẽ để kiểm định mô hình phức tạp hơn. Phân tích biến trung gian AMOS và phân tích biến trung gian SmartPLS cho phép kiểm định nhiều biến trung gian cùng lúc trong một biến trung gian trong mô hình SEM hoàn chỉnh, cũng dựa trên nguyên lý Bootstrapping.
Ý Nghĩa Của Phân Tích Biến Trung Gian Trong Nghiên Cứu Khoa Học
Tầm quan trọng của phân tích biến trung gian không chỉ nằm ở việc xác nhận một giả thuyết. Nó giúp các nhà nghiên cứu xây dựng và kiểm định các mô hình lý thuyết phức tạp, giải thích sâu hơn về các hiện tượng xã hội, kinh tế, tâm lý. Việc hiểu rõ cơ chế tác động cho phép đưa ra những kiến nghị chính sách hoặc quản trị chính xác và hiệu quả hơn. Một nghiên cứu hoàn thiện không chỉ dừng lại ở việc “cái gì tác động đến cái gì” mà phải đi sâu vào “tác động bằng cách nào”.
Quá trình phân tích biến trung gian đòi hỏi sự cẩn trọng từ khâu xây dựng lý thuyết, làm sạch dữ liệu, đến lựa chọn phương pháp và diễn giải kết quả. Nếu bạn gặp khó khăn trong quá trình xử lý số liệu, chạy mô hình trên SPSS, AMOS, SmartPLS hay cần tư vấn để hoàn thiện mô hình nghiên cứu cho luận văn, đội ngũ chuyên gia của Xulysolieu.info luôn sẵn sàng hỗ trợ bạn.
Hướng dẫn đánh giá mô hình cấu trúc trên SmartPLS 4
Trong nghiên cứu định lượng, đánh giá mô hình cấu trúc (Structural Model Assessment) là bước phân tích then chốt, được thực hiện ngay sau khi mô hình đo lường được xác nhận đạt chuẩn. Bước này có vai trò quyết định trong việc kiểm định các giả thuyết nghiên cứu, xác định mức độ và chiều hướng tác động giữa các khái niệm, qua đó khẳng định giá trị của toàn bộ mô hình. Việc thực hiện đánh giá mô hình cấu trúc một cách chính xác là yêu cầu bắt buộc đối với các luận văn, luận án và bài báo khoa học sử dụng phương pháp SEM.
Bài viết này, được biên soạn bởi các chuyên gia của xulysolieu.info, sẽ cung cấp một hướng dẫn toàn diện từ lý thuyết đến thực hành chi tiết nhất về cách đánh giá mô hình cấu trúc trên SmartPLS 4, giúp bạn tự tin xử lý dữ liệu và trình bày kết quả một cách chuyên nghiệp.
Tại sao nên lựa chọn SmartPLS 4 cho đánh giá mô hình cấu trúc?
Khi tiếp cận phân tích mô hình phương trình cấu trúc (SEM), các nhà nghiên cứu thường phân vân giữa hai phương pháp chính: CB-SEM (thường dùng AMOS) và PLS-SEM (thường dùng SmartPLS). SmartPLS 4, với thuật toán PLS-SEM, đã trở thành lựa chọn hàng đầu cho nhiều nghiên cứu hiện đại nhờ những ưu điểm vượt trội và tính linh hoạt cao. Đây là công cụ không thể thiếu khi bạn thực hiện đánh giá mô hình cấu trúc SEM.
PLS-SEM tỏ ra ưu việt hơn CB-SEM trong các bối cảnh nghiên cứu cụ thể. Nếu mục tiêu chính của bạn là dự báo một kết quả hoặc khám phá, mở rộng một lý thuyết hiện có, PLS-SEM là lựa chọn tối ưu. Ngược lại, CB-SEM phù hợp hơn cho việc kiểm định và xác nhận các lý thuyết đã được thiết lập vững chắc. Sự linh hoạt này làm cho PLS-SEM trở nên lý tưởng cho các nghiên cứu trong lĩnh vực kinh doanh, marketing và khoa học xã hội, nơi các lý thuyết thường xuyên được phát triển.
Một trong những lợi thế lớn nhất của PLS-SEM là khả năng xử lý dữ liệu không tuân theo phân phối chuẩn. Đây là một vấn đề phổ biến trong các khảo sát thực tế. Vì là một phương pháp phi tham số, PLS-SEM không yêu cầu dữ liệu phải phân phối chuẩn, giúp nhà nghiên cứu tránh được các bước tiền xử lý phức tạp. Hơn nữa, nó hoạt động hiệu quả với cả cỡ mẫu nhỏ và các mô hình có cấu trúc phức tạp, bao gồm nhiều biến tiềm ẩn, biến trung gian, và các thang đo dạng nguyên nhân (formative) – một điểm yếu lớn của CB-SEM.
Các tiêu chí cần đạt trước khi tiến hành đánh giá mô hình cấu trúc
Trước khi bắt tay vào việc đánh giá mô hình cấu trúc, bạn phải đảm bảo rằng mô hình đo lường của mình đã “khỏe mạnh”. Đây là bước nền tảng không thể bỏ qua, vì một mô hình đo lường yếu sẽ dẫn đến các kết quả phân tích cấu trúc sai lệch và không đáng tin cậy. Việc chuẩn bị dữ liệu và kiểm định mô hình đo lường kỹ lưỡng sẽ quyết định sự thành công của toàn bộ quá trình phân tích.
Đầu tiên, độ tin cậy của thang đo phải được xác nhận. Hai chỉ số quan trọng nhất là Cronbach’s Alpha và Độ tin cậy tổng hợp (Composite Reliability – CR). Theo tiêu chuẩn chung, cả hai hệ số này đều phải đạt giá trị từ 0.7 trở lên để khẳng định các biến quan sát trong cùng một thang đo là nhất quán và đo lường tốt cho một khái niệm nghiên cứu.
Tiếp theo, giá trị hội tụ và giá trị phân biệt là hai yếu tố cốt lõi. Giá trị hội tụ đảm bảo rằng các biến quan sát của cùng một khái niệm có liên quan chặt chẽ với nhau. Điều này được kiểm tra qua hệ số tải ngoài (Outer Loading) phải lớn hơn 0.7 và Phương sai trích trung bình (Average Variance Extracted – AVE) phải lớn hơn 0.5. Về giá trị phân biệt, nó khẳng định rằng các khái niệm nghiên cứu trong mô hình là khác biệt nhau. Tiêu chí phổ biến và mạnh mẽ nhất hiện nay là HTMT (Heterotrait-Monotrait Ratio of Correlations), với giá trị yêu cầu phải nhỏ hơn 0.85 hoặc 0.90. Chỉ khi tất cả các tiêu chí này được thỏa mãn, bạn mới có thể tự tin chuyển sang bước đánh giá mô hình cấu trúc.
Các bước cụ thể thực hiện trên SmartPLS 4

Để thực hiện việc đánh giá mô hình cấu trúc một cách đầy đủ và chuẩn xác trên phần mềm SmartPLS 4, bạn cần tuần tự thực hiện ba thuật toán chính. Mỗi thuật toán phục vụ một mục đích riêng, cung cấp các chỉ số cần thiết để đưa ra kết luận toàn diện về mô hình.
Bước 1: Chạy thuật toán PLS-SEM để lấy kết quả ban đầu

Thuật toán này là bước khởi đầu, cung cấp các hệ số nền tảng để đánh giá tổng quan mô hình, bao gồm hệ số VIF (kiểm tra đa cộng tuyến), R-squared (mức độ giải thích), và f-squared (mức độ ảnh hưởng).
- Thao tác cài đặt: Từ giao diện chính của SmartPLS 4, bạn vào menu Calculate và chọn PLS-SEM Algorithm. Trong cửa sổ cài đặt, hãy giữ nguyên các thông số mặc định như “Path” cho Weighting Scheme và “Maximum Iterations” là 300. Nhấn Start Calculation để chạy thuật toán.
- Xem kết quả VIF, R-squared, và f-squared: Sau khi chạy xong, SmartPLS sẽ hiển thị một menu kết quả. Bạn có thể truy cập các chỉ số này tại các mục tương ứng: “Collinearity Statistics (VIF)”, “R Square”, và “f Square”. Việc đọc và diễn giải các chỉ số này là bước đầu tiên trong quy trình đánh giá mô hình cấu trúc.
Bước 2: Kiểm định độ tin cậy qua Bootstrapping
Bootstrapping là một kỹ thuật lấy mẫu lặp lại nhằm ước tính sai số chuẩn, từ đó tính toán giá trị T-statistics và P-value. Đây là bước quyết định để kết luận các giả thuyết nghiên cứu có được ủng hộ hay không.
- Cách thực hiện Bootstrapping: Quay trở lại mô hình, vào menu Calculate và chọn Bootstrapping. Trong cửa sổ cài đặt, phần quan trọng nhất là “Subsamples”. Theo khuyến nghị của Hair và cộng sự (2019), bạn nên nhập số mẫu lặp lại tối thiểu là 5,000 để đảm bảo kết quả có ý nghĩa thống kê và ổn định. Chọn phương pháp “Bias-Corrected and Accelerated (BCa) Bootstrap” và loại kiểm định “Two-tailed”.
- Diễn giải kết quả: Kết quả Bootstrapping sẽ hiển thị trong mục “Path Coefficients”. Tại đây, bạn cần tập trung vào cột “Original Sample” (chính là hệ số beta – β), “T Statistics”, và đặc biệt là “P Values” để đối chiếu với các giả thuyết nghiên cứu đã đặt ra. Đây là trái tim của việc đánh giá mô hình cấu trúc SmartPLS.
Bước 3: Sử dụng PLSpredict để đánh giá khả năng dự báo
Đây là một cải tiến quan trọng của SmartPLS 4 so với các phiên bản trước. Thuật toán Blindfolding (cho ra chỉ số Q² truyền thống) đã bị loại bỏ vì chỉ có khả năng đánh giá dự báo trong mẫu (in-sample). PLSpredict cung cấp một thước đo chính xác hơn về khả năng dự báo ngoài mẫu (out-of-sample).
- Điểm mới trong SmartPLS 4: Việc chuyển từ Blindfolding sang PLSpredict phản ánh sự thay đổi trong tiêu chuẩn đánh giá mô hình PLS-SEM, nhấn mạnh hơn vào năng lực dự báo thực tiễn thay vì chỉ phù hợp với dữ liệu có sẵn.
- Các bước thực hiện và cài đặt cần thiết: Vào menu Calculate và chọn PLSpredict. Các cài đặt mặc định (10 folds, 10 repetitions) thường được giữ nguyên. Sau khi chạy, bạn sẽ xem kết quả ở mục “LV Prediction Summary”. Nếu tất cả giá trị Q2predict đều lớn hơn 0 và sai số của mô hình PLS (RMSE, MAE) nhỏ hơn mô hình LM, mô hình của bạn có khả năng dự báo tốt.
Diễn giải và phân tích các chỉ số trong cấu trúc mô hình

Sau khi đã có đầy đủ kết quả từ các thuật toán, bước tiếp theo là diễn giải và phân tích các chỉ số để hoàn thành việc đánh giá mô hình cấu trúc. Quy trình này cần tuân thủ các tiêu chuẩn học thuật để đảm bảo tính chặt chẽ và thuyết phục.
Tiêu chí đánh giá hiện tượng đa cộng tuyến
Đa cộng tuyến xảy ra khi hai hay nhiều biến độc lập trong mô hình có tương quan quá cao với nhau, gây nhiễu loạn kết quả ước lượng. Việc kiểm tra đa cộng tuyến là bước phải làm trước khi xem xét các mối quan hệ.
- Kiểm tra VIF: Trong kết quả của “PLS-SEM Algorithm”, vào mục “Collinearity Statistics (VIF)” và chọn tab “Inner VIF Values”. Chỉ số VIF (Variance Inflation Factor) được dùng để phát hiện đa cộng tuyến. Theo Hair và cộng sự (2019), ngưỡng lý tưởng là VIF < 3.0. Nếu VIF từ 3.0 đến 5.0, có thể có vấn đề. Nếu VIF ≥ 5.0, hiện tượng đa cộng tuyến là nghiêm trọng và cần được xử lý.
- Hành động cần làm: Khi VIF vượt ngưỡng 5.0, bạn cần xem xét loại bỏ biến có VIF cao nhất hoặc kết hợp các biến có khái niệm tương đồng thành một nhân tố bậc cao hơn (nếu cơ sở lý thuyết cho phép). Việc này đảm bảo tính chính xác cho các bước đánh giá mô hình cấu trúc sau đó.
Kiểm tra mẫu giả thuyết và ý nghĩa thống kê

Đây là phần cốt lõi để trả lời các câu hỏi nghiên cứu. Kết quả từ Bootstrapping sẽ cho biết liệu các mối quan hệ giả định có thực sự tồn tại trong thực tế hay không.
- Hệ số tác động Path Coefficients: Trong bảng kết quả “Path Coefficients”, cột “Original Sample” (β) cho biết chiều và độ lớn của tác động. Giá trị dương thể hiện tác động cùng chiều, giá trị âm thể hiện tác động ngược chiều. Giá trị tuyệt đối càng gần 1, tác động càng mạnh.
- Đánh giá giả thuyết với P-value: Cột “P Values” là tiêu chí quyết định. Với mức ý nghĩa 5%, nếu P-value < 0.05, mối quan hệ có ý nghĩa thống kê và giả thuyết nghiên cứu được chấp nhận. Ngược lại, nếu P-value ≥ 0.05, mối quan hệ không có ý nghĩa thống kê và giả thuyết bị bác bỏ.
Đánh giá sức mạnh giải thích với R-squared và f-squared
Ngoài việc xác định ý nghĩa thống kê, một phần quan trọng của đánh giá mô hình cấu trúc là xem xét mức độ giải thích và tầm quan trọng thực tiễn của các mối quan hệ. Hai chỉ số R-squared và f-squared sẽ giúp bạn làm điều này.
Hệ số xác định R-squared

Hệ số xác định (R²) đo lường phần trăm sự biến thiên của một biến phụ thuộc được giải thích bởi các biến độc lập tác động lên nó. Đây là một chỉ số quan trọng để đánh giá sức mạnh tổng thể của mô hình.
- Diễn giải và cách đọc giá trị của R-squared adjusted: Trong kết quả của “PLS-SEM Algorithm”, hãy xem chỉ số “R Square Adjusted”. Giá trị này đã được hiệu chỉnh cho số lượng biến độc lập trong mô hình. Ví dụ, R2adjusted = 0.582 có nghĩa là các biến độc lập giải thích được 58.2% sự thay đổi của biến phụ thuộc. Theo Cohen (1988), các mức độ giải thích được gợi ý là 0.25 (yếu), 0.50 (trung bình), và 0.75 (mạnh). Tuy nhiên, trong khoa học xã hội, R² trên 0.20 đã được xem là có giá trị.
Sức mạnh của f-squared
Trong khi R² đánh giá sức mạnh giải thích chung, f-squared (f²) lại đo lường mức độ đóng góp của từng biến độc lập riêng lẻ vào R² của biến phụ thuộc. Điều này giúp xác định tầm quan trọng của mỗi mối quan hệ.
- Hiểu rõ về ảnh hưởng của biến độc lập đối với biến phụ thuộc: Kết quả f² cũng có trong báo cáo của “PLS-SEM Algorithm”. Các ngưỡng đánh giá theo Cohen (1988) là: f2 < 0.02 (không có ảnh hưởng), 0.02 ≤ f2 < 0.15 (ảnh hưởng nhỏ), 0.15 ≤ f2 < 0.35 (ảnh hưởng trung bình), và f2 ≥ 0.35 (ảnh hưởng lớn). Chỉ số này rất hữu ích để so sánh và xếp hạng mức độ quan trọng của các yếu tố tác động.
Giải quyết các vấn đề thường gặp trong đánh giá mô hình
Không phải lúc nào quá trình đánh giá mô hình cấu trúc cũng cho ra kết quả đẹp như mong đợi. Việc gặp phải các vấn đề như đa cộng tuyến hay giả thuyết bị bác bỏ là điều bình thường. Điều quan trọng là biết cách xử lý và lập luận một cách khoa học.
Các hiện tượng phổ biến và cách khắc phục
- Giá trị VIF cao: Nguyên nhân thường do các khái niệm nghiên cứu quá giống nhau, khiến người trả lời không phân biệt được.
- Ví dụ thực tế: Trong một mô hình nghiên cứu về lòng trung thành, hai biến độc lập “Chất lượng cảm nhận” và “Sự hài lòng” có thể có VIF cao vì chúng đo lường những khía cạnh rất gần nhau trong tâm trí khách hàng.
- Cách xử lý: Bạn có thể xem xét loại bỏ một trong hai biến hoặc, nếu lý thuyết ủng hộ, gộp chúng thành một khái niệm bậc cao hơn là “Trải nghiệm tích cực”.
- Giả thuyết không đạt: Khi P-value > 0.05, giả thuyết của bạn bị bác bỏ.
- Cách xử lý và lập luận: Tuyệt đối không được chỉnh sửa số liệu. Thay vào đó, hãy tìm một lời giải thích hợp lý. Có thể bối cảnh nghiên cứu của bạn (văn hóa, đặc điểm mẫu) khác biệt so với các nghiên cứu trước.
- Ví dụ thực tế: Giả thuyết “Quảng cáo trên TikTok tác động đến ý định mua sản phẩm X” bị bác bỏ. Lập luận có thể là: “Kết quả cho thấy quảng cáo TikTok không ảnh hưởng đến ý định mua hàng (p > 0.05). Điều này có thể được giải thích do đối tượng khách hàng mục tiêu của sản phẩm X (ví dụ: người trên 50 tuổi) không phải là người dùng thường xuyên của nền tảng này, do đó hiệu quả quảng cáo không đạt được.” Hoặc, có thể tác động này là gián tiếp thông qua một biến trung gian như “Nhận diện thương hiệu”.
Hướng dẫn trình bày kết quả một cách chuẩn mực trong luận văn
Trình bày kết quả rõ ràng, logic và tuân thủ chuẩn mực học thuật là yếu tố then chốt để được đánh giá cao. Việc sử dụng bảng biểu và văn phong chuyên nghiệp sẽ giúp hội đồng dễ dàng theo dõi và công nhận kết quả nghiên cứu của bạn. Quá trình đánh giá mô hình cấu trúc SEM sẽ không hoàn chỉnh nếu thiếu bước này.
Mẫu bảng trình bày kết quả mô hình cấu trúc
Bạn nên tổng hợp tất cả các kết quả quan trọng vào một bảng duy nhất để người đọc dễ dàng theo dõi.
- Cấu trúc bảng tổng hợp: Bảng cần có các cột: Giả thuyết, Mối quan hệ, Hệ số tác động (β), Trị số T (T Statistics), Giá trị P (P Value), Kết luận (Chấp nhận/Bác bỏ), và có thể thêm cột f² để đánh giá mức độ ảnh hưởng.
| Giả thuyết | Mối quan hệ | Hệ số tác động (β) | Trị số t | Giá trị p | Kết luận | f² |
|---|---|---|---|---|---|---|
| H1 | Chất lượng DV → Sự hài lòng | 0.451 | 5.892 | 0.000 | Chấp nhận | 0.231 (Trung bình) |
| H2 | Giá cả → Sự hài lòng | 0.103 | 1.211 | 0.226 | Bác bỏ | 0.012 (Không ảnh hưởng) |
| H3 | Sự hài lòng → Lòng trung thành | 0.612 | 8.345 | 0.000 | Chấp nhận | 0.415 (Lớn) |
(Lưu ý: Kèm theo bảng này là diễn giải về kết quả VIF và R-squared)
Cách thức viết nhận xét và giải thích trong luận văn
Sau khi trình bày bảng, bạn cần viết một đoạn văn diễn giải chi tiết.
- Hướng dẫn cách hành văn:
Về kiểm định giả thuyết: “Kết quả phân tích Bootstrapping với 5,000 mẫu lặp lại (trình bày ở Bảng X) cho thấy, giả thuyết H1 được chấp nhận ở mức ý nghĩa 1% (β = 0.451, t = 5.892, p < 0.001). Điều này khẳng định Chất lượng dịch vụ có tác động tích cực và có ý nghĩa thống kê đến Sự hài lòng. Mức độ ảnh hưởng này là ở mức trung bình (f² = 0.231). Ngược lại, giả thuyết H2 bị bác bỏ vì mối quan hệ giữa Giá cả và Sự hài lòng không có ý nghĩa thống kê (β = 0.103, p = 0.226 > 0.05).”
Về mức độ giải thích của mô hình: “Kết quả phân tích cho thấy hệ số R² hiệu chỉnh của biến Sự hài lòng là 0.554 và của biến Lòng trung thành là 0.375. Điều này có nghĩa là mô hình nghiên cứu giải thích được 55.4% sự biến thiên của Sự hài lòng và 37.5% sự biến thiên của Lòng trung thành. Các giá trị này được xem là ở mức trung bình đến mạnh, cho thấy mô hình có năng lực giải thích tốt trong bối cảnh nghiên cứu.”
Bằng việc tuân thủ quy trình đánh giá mô hình cấu trúc chi tiết này, bạn không chỉ đảm bảo tính chính xác khoa học mà còn nâng cao chất lượng và tính thuyết phục cho luận văn của mình. Nếu bạn gặp khó khăn trong quá trình phân tích hay xử lý các vấn đề phát sinh, đừng ngần ngại tìm đến sự hỗ trợ chuyên nghiệp.
Hướng dẫn xử lý biến trung gian trên SmartPLS 3
Phân tích biến trung gian là một kỹ thuật không thể thiếu để làm sâu sắc thêm kết quả nghiên cứu, giúp lý giải cơ chế “tại sao” và “thông qua đâu” mà một biến độc lập lại có thể tác động đến biến phụ thuộc. Tuy nhiên, nhiều nhà nghiên cứu, từ sinh viên đến học viên cao học, thường gặp khó khăn trong việc thực hiện kiểm định và diễn giải kết quả một cách chính xác trên phần mềm SmartPLS 3.
Bài viết này sẽ là cẩm nang chi tiết từ A–Z, hướng dẫn bạn từng bước xử lý, phân tích và trình bày kết quả về biến trung gian một cách chuyên nghiệp, đảm bảo tính khoa học và ứng dụng cao cho luận văn, luận án của mình.
1. Khái Niệm Cơ Bản Và Tầm Quan Trọng Của Biến Trung Gian

1.1. Biến Trung Gian Là Gì?
Biến trung gian (tiếng Anh: mediator variable) là một biến thứ ba đóng vai trò là cầu nối, giải thích mối quan hệ nhân quả giữa biến độc lập (X) và biến phụ thuộc (Y). Thay vì chỉ xác nhận rằng X ảnh hưởng đến Y, việc đưa một biến trung gian (M) vào mô hình giúp làm rõ rằng tác động của X lên Y được truyền tải thông qua M. Mối quan hệ này có thể được biểu diễn dưới dạng chuỗi nhân quả: X → M → Y.
Ví dụ, trong lĩnh vực marketing, một nghiên cứu muốn tìm hiểu tác động của “Chất lượng dịch vụ” (X) đến “Lòng trung thành của khách hàng” (Y). Thay vì chỉ kiểm định đường dẫn trực tiếp, nhà nghiên cứu có thể đưa “Sự hài lòng của khách hàng” (M) vào làm biến trung gian. Mô hình lúc này sẽ cho thấy rằng chất lượng dịch vụ tốt sẽ làm tăng sự hài lòng, và chính sự hài lòng này mới dẫn đến lòng trung thành.
Về bản chất, biến trung gian trả lời cho câu hỏi “Cơ chế nào đứng sau mối quan hệ này?”. Việc xác định được yếu tố này không chỉ làm tăng giá trị học thuật mà còn mang lại những gợi ý quản trị thực tiễn và sâu sắc hơn.
1.2. Vai Trò Của Biến Trung Gian Trong Nghiên Cứu Khoa Học
Trong nghiên cứu khoa học, vai trò của biến trung gian là vô cùng quan trọng vì nó giúp mở ra “hộp đen” của các mối quan hệ nhân quả. Thay vì chấp nhận một mối liên hệ bề mặt, nhà nghiên cứu có thể đào sâu vào cơ chế hoạt động, từ đó cung cấp một lời giải thích toàn diện và thuyết phục hơn.
Hãy xem xét một ví dụ trong lĩnh vực quản trị nhân sự: một công ty triển khai “Chính sách đào tạo” (biến độc lập) với hy vọng tăng “Mức độ hài lòng trong công việc” (biến phụ thuộc) của nhân viên. Phân tích trực tiếp có thể cho thấy một tác động yếu. Tuy nhiên, nếu đưa “Năng lực chuyên môn được cải thiện” vào làm một biến trung gian, kết quả có thể sẽ rõ ràng hơn rất nhiều. Chính sách đào tạo giúp nhân viên nâng cao năng lực, và chính việc cảm thấy mình giỏi hơn, làm việc hiệu quả hơn mới là nguyên nhân trực tiếp dẫn đến sự hài lòng.
Việc xác định đúng biến trung gian không chỉ làm phong phú thêm cơ sở lý thuyết mà còn giúp các nhà quản lý đưa ra quyết định chính xác hơn. Trong ví dụ trên, thay vì chỉ tập trung vào việc tổ chức đào tạo, doanh nghiệp cần đảm bảo chương trình đào tạo đó thực sự nâng cao được năng lực cho nhân viên.
2. Quy Trình Kiểm Định Biến Trung Gian Trên SmartPLS 3
Để kiểm định một biến trung gian trên SmartPLS 3, bạn cần tuân thủ một quy trình chặt chẽ, bắt đầu từ khâu chuẩn bị dữ liệu cho đến khi chạy phân tích bootstrapping.
2.1. Các Bước Chuẩn Bị Dữ Liệu
Chất lượng của dữ liệu đầu vào quyết định trực tiếp đến độ tin cậy của kết quả phân tích. Trước khi đưa dữ liệu vào SmartPLS, bạn cần đảm bảo đã hoàn thành các bước sau:
- Làm sạch dữ liệu: Kiểm tra và xử lý các giá trị thiếu (missing values), các giá trị ngoại lai (outliers) có thể gây nhiễu kết quả.
- Mã hóa dữ liệu: Đảm bảo tất cả các biến quan sát đã được mã hóa dưới dạng số và nhất quán theo thang đo đã thiết kế (ví dụ: thang đo Likert 5 điểm từ 1 đến 5).
- Thiết lập mô hình trong SmartPLS: Sau khi nhập dữ liệu, bạn tiến hành vẽ mô hình nghiên cứu.
- Outer model (Mô hình đo lường): Vẽ các mối quan hệ từ biến tiềm ẩn (hình tròn) đến các biến quan sát (hình chữ nhật).
- Inner model (Mô hình cấu trúc): Vẽ các mũi tên thể hiện mối quan hệ giả thuyết giữa các biến tiềm ẩn. Đối với mô hình có biến trung gian, bạn cần vẽ các đường dẫn: từ Biến độc lập (X) đến Biến trung gian (M), từ Biến trung gian (M) đến Biến phụ thuộc (Y), và cả đường dẫn trực tiếp từ Biến độc lập (X) đến Biến phụ thuộc (Y).
2.2. Thiết Lập Phân Tích Bootstrapping
Bootstrapping là kỹ thuật cốt lõi trong PLS-SEM để kiểm định ý nghĩa thống kê của các hệ số đường dẫn, đặc biệt là tác động gián tiếp. Đây là phương pháp lấy mẫu lặp lại có thay thế từ mẫu gốc để tạo ra một phân phối lấy mẫu, từ đó ước tính sai số chuẩn và giá trị p-value.
Để cấu hình Bootstrapping trong SmartPLS, bạn thực hiện như sau:
- Sau khi đã vẽ xong mô hình, vào menu Calculate → Bootstrapping.
- Một hộp thoại cấu hình sẽ hiện ra. Bạn cần thiết lập các thông số sau:
- Subsamples: Nhập số mẫu lặp lại. Theo khuyến nghị của các chuyên gia hàng đầu như Hair và cộng sự (2017), bạn nên chọn 5,000 mẫu để đảm bảo kết quả ổn định và đáng tin cậy.
- Confidence Interval Method: Chọn Bias-Corrected and Accelerated (BCa) Bootstrap. Đây là phương pháp được khuyến nghị vì nó cho ra khoảng tin cậy chính xác nhất, đặc biệt khi dữ liệu không tuân theo phân phối chuẩn.
- Nhấn nút Start Calculation để phần mềm bắt đầu chạy phân tích.
3. Diễn Giải Kết Quả Kiểm Định Biến Trung Gian
Sau khi SmartPLS chạy xong bootstrapping, việc quan trọng nhất là đọc và diễn giải các chỉ số một cách chính xác để kết luận về vai trò của biến trung gian.
3.1. Cách Đọc Các Chỉ Số Quan Trọng
Trong cửa sổ kết quả, bạn cần chú ý đến các mục chính sau:
- Path Coefficients: Bảng này cho thấy các tác động trực tiếp trong mô hình. Bạn sẽ tìm thấy hệ số đường dẫn, giá trị T-Statistics và P-Values cho mối quan hệ X → Y (Direct Effect).
- Specific Indirect Effects: Đây là bảng quan trọng nhất để kiểm định biến trung gian. Bảng này cung cấp hệ số tác động gián tiếp (Indirect Effect) của đường dẫn X → M → Y, cùng với giá trị p-value và khoảng tin cậy.
- Total Effects: Bảng này thể hiện tổng tác động từ X đến Y, bao gồm cả trực tiếp và gián tiếp.
Để kết luận một tác động có ý nghĩa thống kê hay không, bạn cần dựa vào hai chỉ số:
- P-Value: Nếu p-value < 0.05, tác động đó có ý nghĩa thống kê ở mức tin cậy 95%.
- Confidence Intervals (Khoảng tin cậy): Nếu khoảng tin cậy (ví dụ: BCa 95%) không chứa giá trị 0, tác động đó có ý nghĩa thống kê. Ví dụ, khoảng [0.105; 0.215] là có ý nghĩa, trong khi khoảng [-0.022; 0.194] không có ý nghĩa vì nó chứa số 0.
3.2. Phân Loại Loại Trung Gian
Dựa trên kết quả kiểm định, vai trò của biến trung gian được chia thành hai loại chính:
- Trung gian toàn phần (Full Mediation): Xảy ra khi:
- Tác động gián tiếp (X → M → Y) có ý nghĩa thống kê (p < 0.05).
- Tác động trực tiếp (X → Y) không có ý nghĩa thống kê (p > 0.05) sau khi đã đưa biến trung gian vào mô hình.
- Diễn giải: Toàn bộ ảnh hưởng từ biến độc lập đến biến phụ thuộc đều được truyền tải hoàn toàn thông qua biến trung gian.
- Trung gian một phần (Partial Mediation): Xảy ra khi:
- Tác động gián tiếp (X → M → Y) có ý nghĩa thống kê (p < 0.05).
- Tác động trực tiếp (X → Y) vẫn có ý nghĩa thống kê (p < 0.05).
- Diễn giải: Biến độc lập vừa tác động trực tiếp đến biến phụ thuộc, vừa tác động gián tiếp thông qua biến trung gian. Biến trung gian chỉ giải thích được một phần cơ chế tác động.
4. Những Chỉ Số Quan Trọng Cần Lưu Ý Trong Phân Tích
Ngoài việc kiểm định giả thuyết, bạn cũng cần đánh giá chất lượng tổng thể của mô hình cấu trúc để đảm bảo kết quả nghiên cứu là vững chắc.
4.1. Hệ Số Đường Dẫn Trực Tiếp Và Gián Tiếp
Việc xem xét cả ba loại hiệu ứng là rất quan trọng để có cái nhìn toàn cảnh:
- Direct Effect (Tác động trực tiếp): Cho biết ảnh hưởng còn lại của X lên Y sau khi đã kiểm soát M. Sự thay đổi của chỉ số này (từ có ý nghĩa thành không ý nghĩa) là dấu hiệu then chốt để xác định trung gian toàn phần.
- Indirect Effect (Tác động gián tiếp): Đây là chỉ số cốt lõi để khẳng định sự tồn tại của vai trò biến trung gian. Nếu chỉ số này không có ý nghĩa thống kê, ta có thể kết luận không có vai trò trung gian.
- Total Effect (Tổng hiệu ứng): Bằng tổng của tác động trực tiếp và gián tiếp. Chỉ số này cho biết mức độ ảnh hưởng tổng thể của X lên Y, giúp so sánh sức mạnh tương đối của các biến độc lập trong mô hình.
4.2. Đánh Giá Tính Đáng Tin Cậy Của Mô Hình
Để kết quả kiểm định biến trung gian được công nhận, mô hình của bạn phải đáp ứng các tiêu chí chất lượng sau:
- Hệ số VIF (Variance Inflation Factor): Chỉ số này dùng để kiểm tra hiện tượng đa cộng tuyến giữa các biến độc lập cùng dự báo cho một biến phụ thuộc. Các giá trị VIF nên nhỏ hơn 5 (hoặc theo tiêu chuẩn khắt khe hơn là < 3.3). Nếu VIF quá cao, các hệ số hồi quy sẽ không đáng tin cậy. Bạn có thể xem chỉ số này trong kết quả PLS-Algorithm, mục Collinearity Statistics.
- Hệ số R² (R-squared): Đo lường mức độ biến thiên của biến phụ thuộc (và biến trung gian) được giải thích bởi các biến độc lập trong mô hình. Giá trị R² càng cao (gần 1) thì mô hình càng có khả năng giải thích tốt.
- Chỉ số Q² (Predictive Relevance): Đánh giá khả năng dự báo của mô hình đối với các biến nội sinh. Giá trị Q² > 0 cho thấy mô hình có năng lực dự báo. Việc thêm một biến trung gian hữu ích vào mô hình thường sẽ làm tăng cả chỉ số R² và Q² của biến phụ thuộc cuối cùng.
5. Những Lưu Ý Khi Xử Lý Biến Trung Gian

Để tránh những sai lầm phổ biến và nâng cao chất lượng nghiên cứu, hãy ghi nhớ những điểm quan trọng sau.
5.1. Điều Kiện Lý Thuyết Cần Thiết
Việc lựa chọn một biến trung gian không thể thực hiện một cách tùy tiện hay chỉ dựa trên linh cảm. Nó phải được xây dựng trên một nền tảng lý thuyết vững chắc. Trước khi đưa biến M vào mô hình để kiểm định, bạn phải trả lời được câu hỏi: “Tại sao về mặt lý thuyết, X lại có thể tác động đến Y thông qua M?”.
Cơ sở lý thuyết này có thể đến từ các nghiên cứu trước, các học thuyết đã được công nhận, hoặc một lập luận logic chặt chẽ. Một biến trung gian không có nền tảng lý thuyết sẽ làm giảm tính thuyết phục của nghiên cứu, dù kết quả thống kê có ý nghĩa.
5.2. Các Vấn Đề Thường Gặp Khi Làm Việc Với SmartPLS
Trong quá trình phân tích, bạn có thể gặp một số vấn đề khiến kết quả không như mong đợi. Dưới đây là cách giải quyết:
- Tác động gián tiếp không có ý nghĩa (p > 0.05):
- Nguyên nhân: Cỡ mẫu nhỏ, mối quan hệ thực sự yếu, hoặc hiện tượng đa cộng tuyến cao giữa biến độc lập và biến trung gian.
- Giải pháp: Kiểm tra lại chỉ số VIF. Nếu VIF > 5, hãy xem xét loại bỏ các biến quan sát có sự trùng lặp về nội dung. Đồng thời, đảm bảo thang đo của bạn đạt độ tin cậy và giá trị hội tụ.
- Thang đo không đạt độ tin cậy (Cronbach’s Alpha, CR < 0.7) hoặc giá trị hội tụ (AVE < 0.5):
- Nguyên nhân: Các câu hỏi khảo sát bị hiểu sai, không đo lường đúng khái niệm.
- Giải pháp: Vào kết quả PLS Algorithm, xem bảng “Outer Loadings”. Loại bỏ các biến quan sát có hệ số tải thấp (ví dụ, < 0.5) để cải thiện các chỉ số CR và AVE.
- Vi phạm giá trị phân biệt (HTMT > 0.9):
- Nguyên nhân: Các khái niệm nghiên cứu quá gần nhau, người trả lời không phân biệt được (ví dụ: “Sự hài lòng” và “Sự thỏa mãn”).
- Giải pháp: Xem xét lại định nghĩa các khái niệm và các biến quan sát. Có thể cần loại bỏ các biến quan sát gây nhầm lẫn hoặc trong trường hợp xấu nhất là gộp hai khái niệm lại nếu lý thuyết cho phép.
6. Cách Trình Bày Kết Quả Trong Báo Cáo Nghiên Cứu
Trình bày kết quả một cách rõ ràng, chuyên nghiệp là bước cuối cùng để thuyết phục hội đồng khoa học về giá trị nghiên cứu của bạn.
6.1. Gợi Ý Cấu Trúc Trình Bày Hiệu Quả
Một cấu trúc trình bày logic sẽ giúp người đọc dễ dàng theo dõi và nắm bắt kết quả. Bạn nên trình bày theo thứ tự sau:
- Đánh giá mô hình đo lường: Trình bày bảng tổng hợp các chỉ số độ tin cậy (Cronbach’s Alpha, CR), giá trị hội tụ (AVE), và giá trị phân biệt (HTMT) để chứng minh rằng các thang đo của bạn là tốt.
- Đánh giá mô hình cấu trúc: Trình bày các chỉ số R², Q² và VIF.
- Kiểm định giả thuyết: Chèn hình ảnh sơ đồ mô hình từ SmartPLS với các hệ số đường dẫn và p-value được hiển thị. Kèm theo đó là bảng tổng hợp kết quả kiểm định các tác động trực tiếp và gián tiếp.
- Tổng kết và biện luận: Diễn giải ý nghĩa của các kết quả, kết luận giả thuyết nào được chấp nhận/bác bỏ và đặc biệt là kết luận về vai trò của biến trung gian.
6.2. Mẫu Bảng Trình Bày Kết Quả Kiểm Định
Việc sử dụng bảng biểu chuẩn hóa sẽ làm tăng tính chuyên nghiệp cho báo cáo của bạn. Dưới đây là một mẫu bảng tham khảo theo chuẩn APA.
Bảng: Kết quả kiểm định vai trò trung gian (Bootstrapping, N=5000)
| Loại tác động | Đường dẫn | Hệ số (β) | P-Value | Khoảng tin cậy 95% (BCa) | Kết luận |
|---|---|---|---|---|---|
| Trực tiếp | X → Y | 0.122 | 0.082 | [-0.015; 0.245] | Không ý nghĩa |
| Gián tiếp | X → M → Y | 0.238 | 0.002 | [0.107; 0.356] | Có ý nghĩa |
| Tổng hiệu ứng | X → Y (Total) | 0.360 | 0.000 | [0.220; 0.488] | Có ý nghĩa |
Diễn giải kết quả từ bảng:
Kết quả kiểm định bootstrapping cho thấy tác động gián tiếp từ X đến Y thông qua biến trung gian M là có ý nghĩa thống kê (β = 0.238, p = 0.002), và khoảng tin cậy 95% không chứa số 0 [0.107; 0.356]. Trong khi đó, tác động trực tiếp từ X đến Y trở nên không còn ý nghĩa thống kê (β = 0.122, p = 0.082). Những kết quả này cung cấp bằng chứng mạnh mẽ để kết luận rằng M đóng vai trò trung gian toàn phần trong mối quan hệ giữa X và Y.
Việc phân tích biến trung gian bằng SmartPLS 3 không hề phức tạp nếu bạn nắm vững quy trình và ý nghĩa của các chỉ số. Hy vọng bài viết này đã cung cấp cho bạn một lộ trình rõ ràng để thực hiện thành công phần phân tích quan trọng này. Nếu bạn vẫn gặp khó khăn trong việc xử lý dữ liệu, chạy mô hình hay diễn giải kết quả, đội ngũ chuyên gia của Xử Lý Số Liệu Info luôn sẵn sàng hỗ trợ.


